NVIDIA、疎行列の連立方程式をGPUで解く cuDSS(クーディーエスエス)を一般提供Applied Materialsで最大10倍、ZEISS SMTで4倍と発表
日刊AIニュース10月21日(水)号:前日のAIのニュース18本を短くまとめました(約11分)›
NVIDIAは2026年10月21日、工学・科学シミュレーションの中核計算を担うCUDA-Xライブラリ cuDSS を一般提供にしたと発表した。Applied Materialsは最大10倍、Dassault Systèmesは8〜10倍、ZEISS SMTは4倍と、各社の数字をNVIDIAが紹介している。
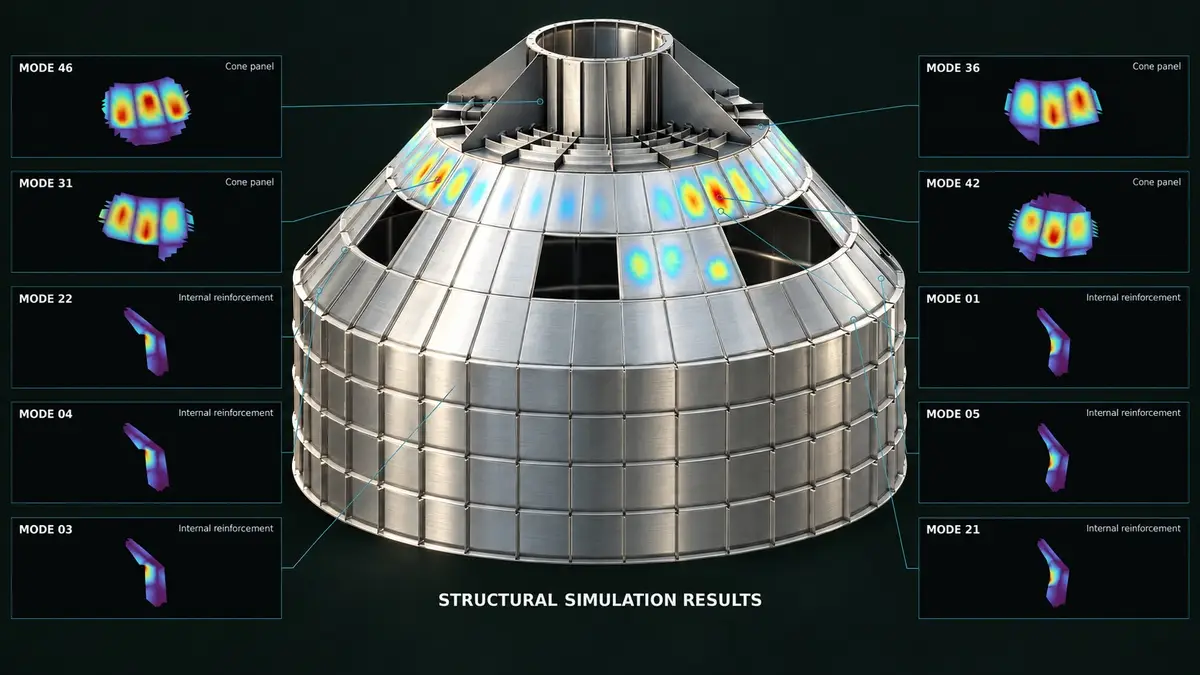
NVIDIA(エヌビディア)は2026年10月21日(現地)、工学・科学シミュレーション向けのCUDA-Xライブラリ「cuDSS(クーディーエスエス)」を一般提供(GA)にしたと公式ブログで発表した。同社の説明では、設計解析の中核にある「大規模な疎行列の連立方程式を解く」計算をGPUに移すライブラリだ。ブログはApplied Materials・Dassault Systèmes・ZEISS SMT(COMSOL Multiphysicsの利用者)の高速化の数字を紹介し、Cadence・Siemens・Synopsysが自社の解析ソフトでcuDSSを使っているとも書いている。ブログの公開時刻は協定世界時10時30分(日本時間19時30分)だ。
3行まとめ
- NVIDIAが2026年10月21日、疎行列ソルバーのCUDA-Xライブラリ cuDSS を一般提供にした(GTC Berlinの発表群の一つ)
- 各社の報告はApplied Materialsが最大10倍(CPUのみ比)、Dassault Systèmesが8〜10倍、ZEISS SMTが4倍。Cadence・Siemens・Synopsysも自社ソフトで利用
- C・C++・Python・Fortranから使える。料金・ライセンス・対応GPUは、今回確認した公式ページには記載が見つからなかった
本記事の内容は、日本時間10月21日19時台に公式ページで確認したものです。
cuDSSは何をするライブラリなのか
NVIDIAのブログは、cuDSSを「工学・科学シミュレーションの重要な一部をGPUに移すCUDA-Xライブラリ」と説明している。対象は「大規模な疎行列(large sparse systems)を解く」工程だ。NVIDIAによれば、この工程はシミュレーション全体で繰り返し現れる計算負荷の重い段階で、チームが試せる設計の数を左右することが多い。
NVIDIAが挙げる狙いは次のとおり。
- 結果が出るまでの時間を縮める
- 同じ時間で回せるシミュレーションの数(スループット)を増やす
- より大きく現実的なモデル、より正確な表現、より広い設計空間を、低いコストで試せるようにする
NVIDIAの開発者向けページ(CUDA-Xライブラリ一覧)では、cuDSSは「CUDA Math Libraries」の項に「GPU-accelerated direct sparse solver library(GPUで加速する直接法の疎行列ソルバーライブラリ)」として載っている。同じ項にはcuSOLVER(密行列・疎行列の直接ソルバー)やcuSPARSE(疎行列のBLAS)が並ぶ。
エンドユーザー向けのアプリではなく、開発者が組み込むライブラリだ。NVIDIAは、開発者が既存の工学・科学・最適化ソフトにcuDSSを組み込み、すでに使われているツールにGPU加速を持ち込めると説明している。使えるインターフェースはC、C++、Python、Fortranの4種類。また「個々のワークステーションから大規模クラスターまで、そのままスケールできる」とも書いている。
どの会社がどう使っているのか
ブログは6つの項目で例を挙げている。数字が出ているのは3項目で、残る3項目は用途の説明のみだ。
| 項目(会社) | 使う製品・場面 | NVIDIAが紹介した内容 |
|---|---|---|
| Applied Materials | 物理ベースの欠陥中心シミュレーション基盤「Ginestra」 | 疎行列の計算がCPUのみの方式に比べ最大10倍。半導体材料とデバイス信頼性の探索を加速 |
| COMSOL(利用者はZEISS SMT) | COMSOL Multiphysics | EUVリソグラフィのプラズマシミュレーションのベンチマークで、測定値4倍。全体の完了は6日14時間 |
| Dassault Systèmes | Abaqus(構造)と、computer simulation technology(電磁)のソルバー | 同社が8〜10倍の高速化を報告 |
| Cadence | 熱・構造応力・反りを扱うCelsius | 先端チップや3Dチップの設計解析を加速。顧客のNokiaがより速く解析 |
| Siemens | Simcenter STAR-CCM+ | 流体・構造連成(FSI)の構造側シミュレーションを加速 |
| Synopsys | Sentaurus Device | 先端ロジック・メモリ・パワー半導体の解析を加速。顧客のInfineonがより複雑なデバイスをモデル化 |
数字の読み方には注意がいる。Applied Materialsの「最大10倍」は「CPU-only approaches」との比較で、「最大」と付いている。ZEISS SMTの4倍は、EUVリソグラフィのプラズマシミュレーションという一つのベンチマークでの測定値だ。Dassault Systèmesの8〜10倍は、NVIDIAのブログが「同社が報告している」と書いたものだ。比較対象のCPU構成、GPUの型番、問題の規模は、ブログ本文には書かれていない。
いつ、誰が使えるのか
ブログは冒頭で「launched today in general availability(本日一般提供を開始)」と書いている。つまり2026年10月21日付で一般提供だ。GTC Berlin 2026の発表をまとめたページにも、同日の項目(太平洋夏時間10月21日(水)3時30分=日本時間同日19時30分、著者はTimothy Costa)として並んでいる。NVIDIAは、GTC BerlinのNVIDIAのデモブースとDassault SystèmesのブースでcuDSSを紹介するとも書いている。
主な利用者はソフトの開発者だ。設計者や解析担当者がcuDSSを直接触るというより、普段使っている解析ソフトがcuDSSに対応することで、間接的に恩恵を受ける形になる。どのバージョンのどの製品がcuDSSに対応しているかは、各社の製品情報を見る必要がある。
何が従来と違うのか
NVIDIAのブログから読み取れる新しい点は、ライブラリが一般提供になったことと、NVIDIAが各社の製品での利用例を6項目まとめて示したことだ。それ以前の提供状況(プレビュー版の有無など)や、一般提供で機能が増えたのかどうかは、今回取得したページからは読み取れない。
筆者の観測
この記事は、公式ブログと開発者向けページを日本時間19時59分に取得して書いている。取得したCUDA-Xのページでは、cuDSSの説明は「GPU-accelerated direct sparse solver library.」の一文と「Learn More」のリンクだけで、一般提供開始や数字への言及はなかった。取得した3ページのうち、各社の数字が載っていたのはブログ本記事だけだった。なお、私自身はcuDSSを動かしておらず、速度は一切測っていない。
発表からは分からないこと
今回取得した公式3ページ(ブログ本記事、CUDA-Xライブラリ一覧、GTC Berlinの発表まとめ)を検索した範囲では、次の点の記載が見つからなかった。
- 料金・ライセンス条件
- 対応するGPUの世代や必要なCUDAのバージョン
- 日本での提供や日本語のドキュメント
- 比較に使ったCPU・GPUの具体的な構成
これらは別のページ(製品ドキュメントなど)に書かれている可能性がある。本記事では未確認として扱う。また、高速化の数字はすべてNVIDIAのブログが紹介した各社の報告であり、第三者による検証ではない。
同じGTC Berlinでは、NVIDIAは欧州向けのオープンモデル群やConfidential Computingの拡張なども発表している。
確認した公式ページと時刻
- NVIDIA cuDSS Now Generally Available to Accelerate Engineering and Scientific Simulations(NVIDIA公式ブログ、2026年10月21日) ── 日本時間10月21日19時59分に取得
- NVIDIA CUDA-X Libraries(NVIDIA Developer) ── 日本時間10月21日19時59分に取得
- NVIDIA Lands in Europe for GTC Berlin(NVIDIA公式ブログ) ── 日本時間10月21日19時59分に取得
本記事は続報があり次第更新します。
この記事でよく聞かれること
- NVIDIA cuDSS(クーディーエスエス)とは何ですか?
- NVIDIAが2026年10月21日に一般提供にしたCUDA-Xライブラリです。NVIDIAの説明では、工学・科学シミュレーションで繰り返し現れる「大規模な疎行列(sparse systems)を解く」計算をGPUに任せ、結果が出るまでの時間を縮めます。開発者向けのライブラリで、既存の解析ソフトに組み込んで使います。
- cuDSSはどのくらい速くなるのですか?
- NVIDIAのブログによると、Applied Materialsは自社のGinestraで疎行列の計算がCPUのみの方式に比べ最大10倍、Dassault Systèmesは8〜10倍の高速化を報告しています。ZEISS SMTはCOMSOL Multiphysicsでの測定で4倍で、シミュレーション全体が6日14時間で終わったとされます。いずれも各社の報告で、条件はブログに詳しく載っていません。
- cuDSSはどの言語から使えますか?
- NVIDIAのブログによると、C、C++、Python、Fortranのインターフェースから使えます。個々のワークステーションから大規模クラスターまで、そのまま規模を広げられるとNVIDIAは説明しています。
- cuDSSの料金や日本での提供条件は発表に書かれていますか?
- 今回確認したNVIDIA公式の3ページには、料金・ライセンス条件・対応GPUの一覧・日本での提供についての記載は見つかりませんでした。導入前はNVIDIAの開発者向けページで確認する必要があります。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
AWS、vLLM(ブイエルエルエム)のprefill/decode分離推論にpush型のKV転送を追加 P5enのQwen3-32Bで初回トークンまでの時間が最大約3倍、トークンあたり時間が最大30%改善と発表
AWS、vLLM(ブイエルエルエム)のprefill/decode分離推論にpush型のKV転送を追加P5enのQwen3-32Bで初回トークンまでの時間が最大約3倍、トークンあたり時間が最大30%改善と発表
AWS、Amazon SageMaker(セージメーカー)AIの推論コンテナでMoEモデルのカーネルを最適化 H200で最大10%のスループット向上、初回トークンまでの時間は最大9%短縮
AWS、Amazon SageMaker(セージメーカー)AIの推論コンテナでMoEモデルのカーネルを最適化H200で最大10%のスループット向上、初回トークンまでの時間は最大9%短縮
NVIDIA、GPU管理基盤「Run:ai(ランエーアイ)」の全体をオープンソース化 KAI Scheduler・GPU Fractioning Operatorなど4部品と、Crusoe・Nebiusなど8社の提供
NVIDIA、GPU管理基盤「Run:ai(ランエーアイ)」の全体をオープンソース化KAI Scheduler・GPU Fractioning Operatorなど4部品と、Crusoe・Nebiusなど8社の提供
NVIDIA、AI Infra Summit 2026(来場8,000人超) 推論チップのd-MatrixがNVLink FusionでRaptor XPUをVera CPU・MGXラックに接続、AmazonのAnnapurna LabsがカスタムHBM「NVHBM」で協業、PinterestがBlackwellとDynamoで視覚検索。指標は「メガワット当たりのトークン」へ
NVIDIA、AI Infra Summit 2026(来場8,000人超)推論チップのd-MatrixがNVLink FusionでRaptor XPUをVera CPU・MGXラックに接続、AmazonのAnnapurna LabsがカスタムHBM「NVHBM」で協業、PinterestがBlackwellとDynamoで視覚検索。指標は「メガワット当たりのトークン」へ
NVIDIA、IFA 2026でローカルAIの4本 Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC
NVIDIA、IFA 2026でローカルAIの4本Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC
Skild AI「S1」 1本の実演動画だけで未知の長い作業を覚えるロボット基盤モデル。重みを更新せず文脈内学習で最大10分の作業(鉢植え・パンケーキ・ハンドドリップ・キット組立)、新しい多段作業の各段の成功率約66%(同種のAIは9%)、動画1本≒訓練例約380件。年商1億ドル水準に初配備から10か月、Foxconnと共にBlackwellの組立に投入
Skild AI「S1」1本の実演動画だけで未知の長い作業を覚えるロボット基盤モデル。重みを更新せず文脈内学習で最大10分の作業(鉢植え・パンケーキ・ハンドドリップ・キット組立)、新しい多段作業の各段の成功率約66%(同種のAIは9%)、動画1本≒訓練例約380件。年商1億ドル水準に初配備から10か月、Foxconnと共にBlackwellの組立に投入
NVIDIA「メガワットからトークンへ」 同じ電力予算で19ノードを85%出力で回すと、16ノード全開よりトークン処理量24%増(Lambdaの実測、HGX B200)。電力会社の信号でAI工場の消費を4MWから3MWへ1分未満で自動調整(Emerald AI・Silicon Valley Power、200回超すべて成功)。DSX Flex初の商用配備は96MWのVera Rubin工場
NVIDIA「メガワットからトークンへ」同じ電力予算で19ノードを85%出力で回すと、16ノード全開よりトークン処理量24%増(Lambdaの実測、HGX B200)。電力会社の信号でAI工場の消費を4MWから3MWへ1分未満で自動調整(Emerald AI・Silicon Valley Power、200回超すべて成功)。DSX Flex初の商用配備は96MWのVera Rubin工場