AWS、Amazon SageMaker(セージメーカー)AIの推論コンテナでMoEモデルのカーネルを最適化H200で最大10%のスループット向上、初回トークンまでの時間は最大9%短縮
AWSは2026年10月13日(米国時間)、Amazon SageMaker AIのLMIコンテナでMoE(Mixture-of-Experts)モデルのカーネルを3件最適化したと公式ブログで発表した。H200でスループット最大10%向上、TTFT(初回トークンまでの時間)最大9%短縮とし、一部はvLLMに還元済みという。
AWS(Amazon Web Services)は2026年10月13日(米国時間。日本時間では10月14日0時台)、Amazon SageMaker(セージメーカー)AIの推論コンテナ「LMI(Large Model Inference)」で、MoE(Mixture-of-Experts)モデル向けのカーネル最適化を3件実施したと公式ブログで発表しました。AWSは、3件を合わせてスループットが最大10%、初回トークンまでの時間(TTFT)が最大9%改善したと説明しています。うち2件はオープンソースの推論エンジンvLLM(ブイエルエルエム)にも取り込まれたとのことです。
3行まとめ
- AWSがSageMaker AIのLMIコンテナで、MoEモデル向けにSwap-AB・FP8のTritonバックエンド切替・JIT再コンパイル除去の3件を実施。
- H200での数字は、Swap-ABが出力スループット2〜4%向上、バックエンド切替が10%向上、再コンパイル除去がTTFT 9%短縮(AWS測定)。
- Swap-ABはvLLM 0.24.0以降、再コンパイル除去はvLLM 0.22.0以降、バックエンド切替はLMI v28コンテナで利用可能とAWSは書いている。
本記事の内容は、日本時間10月14日0時台(取得は0時21分)に公式ページで確認したものです。
何が変わったのか:3件の最適化
AWSのブログによると、MoEは「言語モデルの容量を増やしつつ、1トークンあたりの計算を低く保つ」構造です。同社は、MoEの演算が全体の計算時間の大きな割合を占めるため、ここの非効率がそのまま遅延とコストに響くと説明しています。そのため、カーネル(GPU上で動く小さな計算プログラム)の改善が最も効果の大きい手段だとしています。
ブログに出てくる対象は、トークンの振り分け、データの並べ替え、専門家(エキスパート)ごとの計算を1回のGPU処理にまとめる「fused MoE」です。AWSは、速くなる一方でカーネルの実装とデバッグが難しくなり、GPUの使用率を上げるにはハードウェアごとの最適化が要ると書いています。
| 最適化 | 内容(AWSの説明) | AWSが示した効果(H200) | 提供の形 |
|---|---|---|---|
| Swap-AB | 行列の掛け算を転置して、WGMMA命令の「M=64」固定の枠を埋める | 出力スループット2〜4%向上(大規模MoEモデル) | vLLM 0.24.0以降 |
| FP8のバックエンド切替 | FP8テンソル量子化モデルの実行先を、既定のFLASHINFER_CUTLASSからTritonへ変更 | スループット10%向上 | LMI v28コンテナ |
| JIT再コンパイルの除去 | Tritonが整数引数ごとに再コンパイルするのを止める | TTFT 9%短縮(8-wayテンソル並列) | vLLM 0.22.0以降(PR #42849) |
Swap-AB:デコード時の「空き枠」を減らす
NVIDIAのHopper世代GPUは、WGMMAという命令で行列計算をします。AWSによると、この命令は行方向(M)を64に固定しており、Mが64より小さいと計算の枠が遊んでしまいます。ところが、文章を1トークンずつ生成するデコード段階では、ユーザー1系列あたり1トークンしか処理しないため、Mが64を下回り、1行になることもあります。
AWSは、行列の転置という数学的に等価な変形(B^T × A^T → C^T)で、大きいほうの次元(専門家の出力側)を固定枠の側に置く方法を取ったと説明しています。計算結果は変わらず、枠が埋まり、メモリの先読みも効きやすくなるとのことです。効果は、H200での出力スループットで2〜4%の向上です。AWSはこの最適化をvLLMに還元し、0.24.0以降で使えると書いています。
FP8のバックエンド切替:コードを変えない設定変更
vLLMには、量子化方式に応じてMoEの実行先(Triton、FlashInfer+CUTLASSなど)を振り分ける仕組みがあります。AWSのプロファイリングでは、Hopper上のFP8テンソル量子化モデルでは、既定のFLASHINFER_CUTLASS経路よりTritonバックエンドのほうが一貫して速かったとのことです。AWSは理由として、Tritonが量子化のスケーリング・行列計算・専門家の集約を1回のGPU処理にまとめ、メモリとの往復を減らせる点と、小さいバッチの扱いが得意な点を挙げています。
ブログは、この変更は「純粋な設定変更で、カーネルのコードは触っていない」としたうえで、H200上のFP8量子化fused MoEモデルでエンドツーエンドのスループットが10%上がったと書いています。提供先はLMI v28コンテナです。
JIT再コンパイルの除去:初回トークンまでの時間を縮める
Triton(vLLMの独自カーネルの多くで土台となっているコンパイラ)は、整数の引数を既定で「特殊化」します。AWSによると、まだ見ていない値で呼ばれるたびにJIT(実行時)コンパイルが走るため、系列長やバッチサイズが絶えず変わる推論では、この待ち時間がTTFTを押し上げます。
AWSは、回転位置埋め込みとFP8量子化を融合したカーネル _fused_inv_rope_fp8_quant_per_head が、num_tokens の値が変わるたびに再コンパイルされていたと説明しています。可変長の引数に do_not_specialize の注釈を付けて再コンパイルをなくしたところ、H200・8-wayテンソル並列でTTFTが9%改善したとのことです。複数GPUのうち1枚が再コンパイルで止まると他の7枚が待つため、全体での効果が出たという説明です。AWSは、この最適化もvLLMに還元し、0.22.0以降で使えると書いています。
誰がいつから使えるのか
AWSの記載では、これらの最適化はSageMaker AIのLMI Deep Learning Containerに適用されています。vLLMに還元した2件は、バージョン番号つきで書かれています。
- JIT再コンパイル除去:vLLM 0.22.0以降
- Swap-AB:vLLM 0.24.0以降
- FP8のバックエンド切替:LMI v28コンテナ
自前でvLLMを動かしている場合は、上のバージョン以降に上げることでSwap-ABと再コンパイル除去の恩恵を受けられる、というのがブログからの読み取りです。ただし、AWSが示した数字はH200での測定で、他のGPUや自分のモデルで同じ効果が出るかは、ブログの記載だけでは判断できません。
前と何が違うのか
今回の発表は新しいモデルや新サービスではなく、既存の推論コンテナの中身の改善です。今回取得したブログ本文には、料金や新プランに関する記載はありませんでした。
ブログが示す改善幅は、いずれも1桁のパーセントです。数字だけを見ると小さく見えますが、AWSはMoEの演算が計算時間の大きな割合を占めると書いており、同じGPUで処理できる量が増える方向の改善です。
筆者の確認:本文テキストで見えたこと
日本時間10月14日0時21分に公式ページを取得した時点では、取得したのは英語版のブログで、日本語版があるかどうかは確認していません。取得したテキストには「Figure 1: Swap-AB for WGMMA utilization」というキャプションはありましたが、図の中身や測定結果の表は含まれておらず、数字は本文の文章にあるものだけです。筆者が確認できたのは、AWSが本文に書いた数字そのものに限られます。自分でLMIやvLLMを動かして再現したわけではありません。
まだ分からないこと:数字の条件と日本での扱い
- モデル名:ブログは「代表的なMoEモデルを主な例にした」と書くのみで、今回取得した本文には具体的なモデル名がありません。「大規模MoEモデル」「FP8量子化されたfused MoEモデル」としか読み取れません。
- 測定条件:効果はすべてH200での数字です。入力長・出力長・同時接続数などの条件は、今回取得した本文には書かれていません。同じ構成で他のGPUや他のモデルでも同じ数字になるかは、ブログからは分かりません。
- 「合わせて最大10%」の中身:AWSは結論で「これらの最適化を合わせて最大10%・最大9%」と書いています。ただし本文で示された数字では、10%はFP8のバックエンド切替、9%は再コンパイル除去それぞれの値と同じです。3件を同時に適用した条件での測定結果は、今回取得した本文には示されていません。
- 日本での提供:今回取得した公式ページには、リージョンや日本での提供に関する記載はありません。SageMaker AIの日本リージョンでLMI v28がいつ使えるかは、ブログからは分かりません。
- vLLM側の確認:vLLMのプルリクエスト(#42849)やリリースノートは、今回は取得していません。バージョン番号はAWSのブログの記載をそのまま引いています。
出典と確認時刻
- Mixture-of-Experts kernel engineering on Amazon SageMaker AI(AWS公式ブログ・2026年10月13日付): https://aws.amazon.com/blogs/machine-learning/mixture-of-experts-kernel-engineering-on-amazon-sagemaker-ai/
確認時刻は日本時間2026年10月14日0時21分です。本記事は続報があり次第更新します。
この記事でよく聞かれること
- AWSがSageMaker AIで行ったMoEカーネル最適化とは何ですか?
- AWS公式ブログによると、MoE(Mixture-of-Experts)モデルの推論で使うGPUカーネルに3件の最適化を入れました。行列の掛け順を入れ替える「Swap-AB」(出力スループット2〜4%向上)、FP8テンソル量子化モデルのバックエンドをTritonに切り替える設定変更(スループット10%向上)、Tritonの不要なJIT再コンパイルの除去(TTFT 9%短縮)です。数字はいずれもH200での測定とされています。
- どのコンテナやvLLMのバージョンで使えますか?
- AWSの記載では、FP8のバックエンド切替はAWS Large Model Inference(LMI)v28コンテナで利用できます。Swap-ABはvLLM 0.24.0以降、JIT再コンパイル除去はvLLM 0.22.0以降に取り込まれたと書かれています。
- 「最大10%」「最大9%」はすべてのモデルで出る数字ですか?
- 公式ブログの記載では、10%は「H200上のFP8量子化されたfused MoEモデル」、9%は「H200・8-wayテンソル並列」での値です。ブログは「代表的なMoEモデル」を主な例にしたと書くだけで、モデル名は今回取得した本文に出てきません。自分のモデルで同じ数字になるとは限りません。
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
NCCLに頼らないallreduce SGLangがBlackwell世代のFlashInfer MNNVLワークスペースを使い回す最適化
NCCLに頼らないallreduceSGLangがBlackwell世代のFlashInfer MNNVLワークスペースを使い回す最適化
SGLangが「allgather+scatter」を1回のall-to-allに統合 DeepSeek-V4-Proのデコード時間が320μsから169μsに
SGLangが「allgather+scatter」を1回のall-to-allに統合DeepSeek-V4-Proのデコード時間が320μsから169μsに
モデルの起動待ち時間を2.38倍短縮 SGLangが「CUDAグラフのキャプチャ中にチェックポイントを読み込む」設計に変えた
モデルの起動待ち時間を2.38倍短縮SGLangが「CUDAグラフのキャプチャ中にチェックポイントを読み込む」設計に変えた
vLLMに投機的デコードの新手法「DFlash2」 1H200・GSM8Kで自己回帰の3.51倍のスループット
vLLMに投機的デコードの新手法「DFlash2」1H200・GSM8Kで自己回帰の3.51倍のスループット
NVIDIA、GPU管理基盤「Run:ai(ランエーアイ)」の全体をオープンソース化 KAI Scheduler・GPU Fractioning Operatorなど4部品と、Crusoe・Nebiusなど8社の提供
NVIDIA、GPU管理基盤「Run:ai(ランエーアイ)」の全体をオープンソース化KAI Scheduler・GPU Fractioning Operatorなど4部品と、Crusoe・Nebiusなど8社の提供
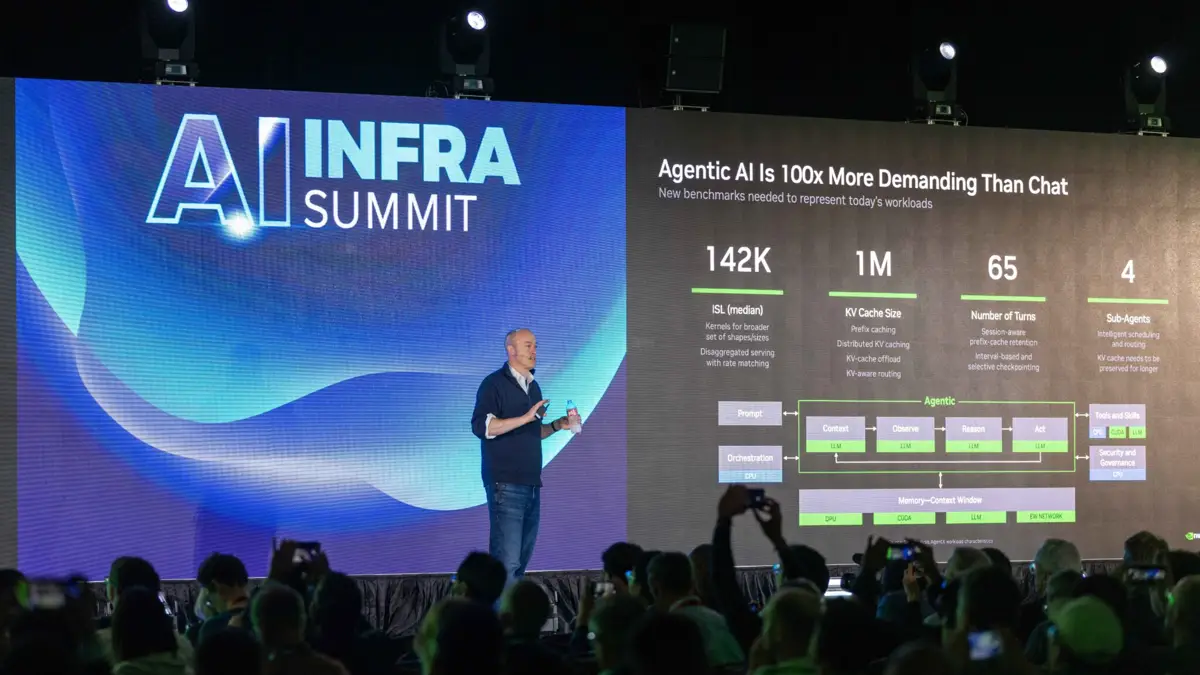
NVIDIA、AI Infra Summit 2026(来場8,000人超) 推論チップのd-MatrixがNVLink FusionでRaptor XPUをVera CPU・MGXラックに接続、AmazonのAnnapurna LabsがカスタムHBM「NVHBM」で協業、PinterestがBlackwellとDynamoで視覚検索。指標は「メガワット当たりのトークン」へ
NVIDIA、AI Infra Summit 2026(来場8,000人超)推論チップのd-MatrixがNVLink FusionでRaptor XPUをVera CPU・MGXラックに接続、AmazonのAnnapurna LabsがカスタムHBM「NVHBM」で協業、PinterestがBlackwellとDynamoで視覚検索。指標は「メガワット当たりのトークン」へ
NVIDIA、IFA 2026でローカルAIの4本 Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC
NVIDIA、IFA 2026でローカルAIの4本Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC