NVIDIA、AI Infra Summit 2026(来場8,000人超)推論チップのd-MatrixがNVLink FusionでRaptor XPUをVera CPU・MGXラックに接続、AmazonのAnnapurna LabsがカスタムHBM「NVHBM」で協業、PinterestがBlackwellとDynamoで視覚検索。指標は「メガワット当たりのトークン」へ
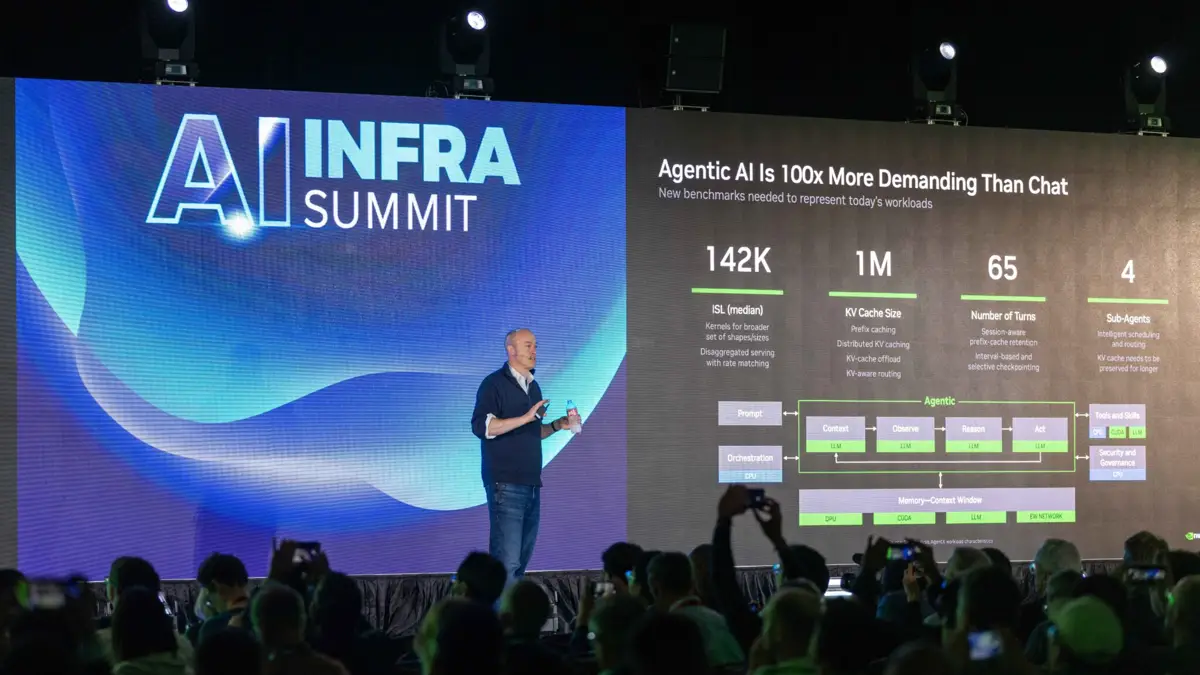
NVIDIAのIan Buck氏は2026年9月15日、AI Infra Summit(来場8,000人超、前年3,500人)で協業と成果を並べた。①AmazonのAnnapurna LabsがNVIDIAとカスタム高帯域メモリNVHBMで協業。②推論チップのd-Matrixが次世代Raptor XPUをNVLink Fusionで接続し、Vera CPU・ConnectX-9・BlueField-4・Spectrum-X・MGXラックと組み合わせて超低遅延推論をラック規模で配備。NVLink Fusionの採用はTrainium4を設計するAWSとd-Matrixで、CPUはArm・x86・RISC-Vに対応しNVLink-C2CはPCIe比で最大6倍の電力効率。③Emerald AIがSilicon Valley Powerで柔軟負荷を実証、④LambdaがDSX MaxLPSでワット当たり23%改善、⑤PinterestがBlackwellとDynamoで会話型の視覚検索。Buck氏は「指標はメガワット当たりの検証済みトークンへ」とし、DSX MaxLPSで最大1.4倍。
2026年9月18日・日本時間時点の情報です。 NVIDIAのブログ2本(9月10日・15日)を読んだ。当サイトは同じ週のDSXの電力管理とMLPerf Inference v6.1を書いたが、Summitで並んだ協業の側(d-Matrix・Annapurna・Pinterest)は扱っていなかった。
3行まとめ
- 会場と主張。 サンタクララのAI Infra Summitは来場8,000人超(前年3,500人)。Ian Buck氏(ハイパースケール・HPC担当VP)は「AI基盤の指標はピーク性能からメガワット当たりの検証済みエージェントトークンへ移っており、AI工場はシリコンから送電網まで共同設計が要る」とし、Vera Rubin・Dynamo推論ソフト・NeMo・NVLink/Spectrum-X/ConnectX/BlueFieldのフルスタックを「10年使える基盤」として売り込んだ。DSX MaxLPSは工場全体の電力最適化で最大1.4倍のトークン/MW(Lambdaの実測はワット当たり23%改善)。
- d-MatrixのNVLink Fusion採用。 推論チップのd-Matrixは、次世代Raptor XPUをNVLink Fusionで接続し、Vera CPU・ConnectX-9 SuperNIC・BlueField-4 DPU・Spectrum-X Ethernet・MGXラックと組み合わせて超低遅延推論をラック規模で配備する。Vera Rubin NVL72と並べた分離推論も想定。CEOのSid Sheth氏は「推論需要は急増しているが資本・時間・電力は有限。MGXの液冷アーキテクチャに載せることで、より速く低リスクに配備できる」。NVLink FusionはNVIDIA GPU間のNVLinkを他社製XPU・CPUに広げたもので、採用はTrainium4を設計するAWSとd-Matrix、エコシステムにAlchip・Arm・Astera Labs・Ayar Labs・Cadence・富士通・GUC・Intel・Lightmatter・Marvell・MediaTek・Samsung・SiFive・Synopsys。CPUはArm・x86・RISC-Vに対応し、NVLink-C2CはPCIe比で最大6倍の電力効率。ラック・冷却・電源・供給網を自前で検証すると「数十億ドルと数年」かかるのを飛ばせる、が売り文句。
- その他の協業。 AmazonのAnnapurna LabsがNVIDIAとカスタム高帯域メモリNVHBMで協業。PinterestがBlackwellとDynamo推論ソフトで会話型の視覚検索を実装。Emerald AIとNVIDIAはSilicon Valley Powerで商用の柔軟負荷プログラムを実証し、Emerald AIはConductorにDSX Flexを使う予定。MLPerf Inference v6.1ではVera Rubin NVL72がGB300 NVL72比最大3.7倍、GB300の288GPU(4ラック)で99%のスケーリング効率、v6.0比でソフトウェアだけで最大1.6倍。
AWS参加の意味とRaptorの空白
- NVLink Fusionは「NVIDIA以外のチップをNVIDIAのラックと供給網に乗せる」枠組みで、**AWS(Trainium4)**が名を連ねる点が大きい。当サイトのメモリ価格高騰の記事で触れたNVHBMも、Annapurnaとの協業として名前が出た
- 「メガワット当たりのトークン」への指標転換はDSXの記事とAEMAで見た文脈と同じで、Summitはその総まとめ
- d-MatrixのRaptorの出荷時期・性能・価格は書かれていない。「次世代」とだけ
- Pinterestの実装の中身(モデル・規模)も一文のみ
確認は2本のブログのみ、現地未参加
この記事の下調べで、筆者は9月18日にNVIDIAのブログ2本を取得し、8,000人超/3,500人・NVHBM・d-Matrixの接続先の部品名・NVLink Fusionの採用者とエコシステム一覧・Arm/x86/RISC-V・6倍・1.4倍・23%・3.7倍・99%・1.6倍がその原文にあることを確認した。d-Matrixの発表とAnnapurna Labsの資料は開いていない。筆者はSummitに参加していない。
Raptor・NVHBM・Pinterestの詳細は不明
- Raptor XPUの仕様・時期・価格
- NVHBMの中身と時期
- Pinterestの実装の規模
参照した記事は9/10と9/15の2本
- AI Infra Summit: NVIDIA Vera Rubin and DSX Platform Advancements Showcase Energy Efficiencies, Tokens per Watt in AI Factories(NVIDIA・2026年9月15日)
- d-Matrix Adopts NVIDIA NVLink Fusion for Rack-Scale XPU Deployment(NVIDIA・2026年9月10日)
関連記事
出典・参照資料

大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
NVIDIA「メガワットからトークンへ」 同じ電力予算で19ノードを85%出力で回すと、16ノード全開よりトークン処理量24%増(Lambdaの実測、HGX B200)。電力会社の信号でAI工場の消費を4MWから3MWへ1分未満で自動調整(Emerald AI・Silicon Valley Power、200回超すべて成功)。DSX Flex初の商用配備は96MWのVera Rubin工場
NVIDIA「メガワットからトークンへ」同じ電力予算で19ノードを85%出力で回すと、16ノード全開よりトークン処理量24%増(Lambdaの実測、HGX B200)。電力会社の信号でAI工場の消費を4MWから3MWへ1分未満で自動調整(Emerald AI・Silicon Valley Power、200回超すべて成功)。DSX Flex初の商用配備は96MWのVera Rubin工場
NVIDIAの次世代ラック「Vera Rubin NVL72」がMLPerf Inference v6.1に初登場 Qwen3-VLでGB300 NVL72の最大3.7倍、DeepSeek-R1で最大2.5倍(プレビュー提出)。GB300は4ラック288GPUで99%のスケーリング効率、ソフトウェア改善だけでv6.0比最大1.6倍。エージェント向け指標では30倍という自社測定も
NVIDIAの次世代ラック「Vera Rubin NVL72」がMLPerf Inference v6.1に初登場Qwen3-VLでGB300 NVL72の最大3.7倍、DeepSeek-R1で最大2.5倍(プレビュー提出)。GB300は4ラック288GPUで99%のスケーリング効率、ソフトウェア改善だけでv6.0比最大1.6倍。エージェント向け指標では30倍という自社測定も
AI投資の主役がGPUからメモリへ TrendForceが示すDRAM価格「2026年に約270%上昇」の内訳
AI投資の主役がGPUからメモリへTrendForceが示すDRAM価格「2026年に約270%上昇」の内訳
Emerald AI・Google・NVIDIAが「AI Energy Management Alliance(AEMA)」を設立 AIデータセンターを「電力を柔軟に減らせる資源」として電力網につなぐ。負荷の移動・蓄電・併設発電で系統の逼迫に応じ、接続前にライドスルー・抑制・緊急応答の義務を定め、検証可能な柔軟性を約束した事業者には速い接続経路を
Emerald AI・Google・NVIDIAが「AI Energy Management Alliance(AEMA)」を設立AIデータセンターを「電力を柔軟に減らせる資源」として電力網につなぐ。負荷の移動・蓄電・併設発電で系統の逼迫に応じ、接続前にライドスルー・抑制・緊急応答の義務を定め、検証可能な柔軟性を約束した事業者には速い接続経路を
AIチップ 業界地図 NVIDIA/AMD/Intel/Apple/独自チップ【2026年】
AIチップ 業界地図NVIDIA/AMD/Intel/Apple/独自チップ【2026年】
NVIDIAがオハイオ州の巨大データセンターを「自社AI計算資源の独占ホスト」に組み替え OpenAIは8IT-GWの「顧客」という立場に
NVIDIAがオハイオ州の巨大データセンターを「自社AI計算資源の独占ホスト」に組み替えOpenAIは8IT-GWの「顧客」という立場に
 動画
日本政府×NVIDIA、フィジカルAI向け"世界初"の国家AIインフラ Rubin GPU 2万7500基・140MWをノエトラが運営へ
日本政府×NVIDIA、フィジカルAI向け"世界初"の国家AIインフラRubin GPU 2万7500基・140MWをノエトラが運営へ