大規模言語モデル(LLM)の記事
「大規模言語モデル(LLM)」に関連するAIニュースと解説、183本。新しい順に並べています。
大規模言語モデル(LLM) の記事:183件
Hugging Face、PyTorch(パイトーチ)のネイティブTPUバックエンド「TorchTPU(トーチTPU)」に対応 Transformers・Diffusers・KernelsがTPUで直接動く
Hugging Face、PyTorch(パイトーチ)のネイティブTPUバックエンド「TorchTPU(トーチTPU)」に対応Transformers・Diffusers・KernelsがTPUで直接動く
検証
OpenAI、APIで「12時間プロンプトキャッシュ」を選べるように 書き込みは入力価格の2.5倍、読み出し料金は30分版と同じ
OpenAI、APIで「12時間プロンプトキャッシュ」を選べるように書き込みは入力価格の2.5倍、読み出し料金は30分版と同じ
プロダクト
Sakana AI(サカナAI)、推薦の「選ぶ理由」を進化させる手法QD-Rec(キューディーレック)を論文とコード付きで公開 M&A・顧客・論文の3課題で、多くの設定で平均評価が高いと報告
Sakana AI(サカナAI)、推薦の「選ぶ理由」を進化させる手法QD-Rec(キューディーレック)を論文とコード付きで公開M&A・顧客・論文の3課題で、多くの設定で平均評価が高いと報告
研究
 動画
MiniMax(ミニマックス)、新モデル「M3.1 Flash」を提供開始 入力$0.15・出力$0.60(100万トークン)、エージェント用途のコストは前世代比70%減と同社
MiniMax(ミニマックス)、新モデル「M3.1 Flash」を提供開始入力$0.15・出力$0.60(100万トークン)、エージェント用途のコストは前世代比70%減と同社
モデル
Amazon、PyTorchのコードを書き換えずにAWS Trainium(トレイニアム)で動かす「TorchNeuron(トーチニューロン)」を10月20日にオープンソース化 Apache 2.0、対応はTrainium2・Trainium3
Amazon、PyTorchのコードを書き換えずにAWS Trainium(トレイニアム)で動かす「TorchNeuron(トーチニューロン)」を10月20日にオープンソース化Apache 2.0、対応はTrainium2・Trainium3
検証
AWS、vLLM(ブイエルエルエム)に双方向KV転送を提供 マルチターンのエージェント処理で初回トークンまでの時間をP5enで最大1.6倍・3.3倍短縮と発表
AWS、vLLM(ブイエルエルエム)に双方向KV転送を提供マルチターンのエージェント処理で初回トークンまでの時間をP5enで最大1.6倍・3.3倍短縮と発表
検証
AWS、vLLM(ブイエルエルエム)のprefill/decode分離推論にpush型のKV転送を追加 P5enのQwen3-32Bで初回トークンまでの時間が最大約3倍、トークンあたり時間が最大30%改善と発表
AWS、vLLM(ブイエルエルエム)のprefill/decode分離推論にpush型のKV転送を追加P5enのQwen3-32Bで初回トークンまでの時間が最大約3倍、トークンあたり時間が最大30%改善と発表
検証
 動画
DeepSeek(ディープシーク)、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をMITライセンスで公開 Terminal-Bench 4.0は31.2から42.3、表の11項目すべてで旧版を上回る(同社掲載の数字)
DeepSeek(ディープシーク)、V4.1-Flashの更新版「DeepSeek-V4.1-Flash-1017」をMITライセンスで公開Terminal-Bench 4.0は31.2から42.3、表の11項目すべてで旧版を上回る(同社掲載の数字)
モデル
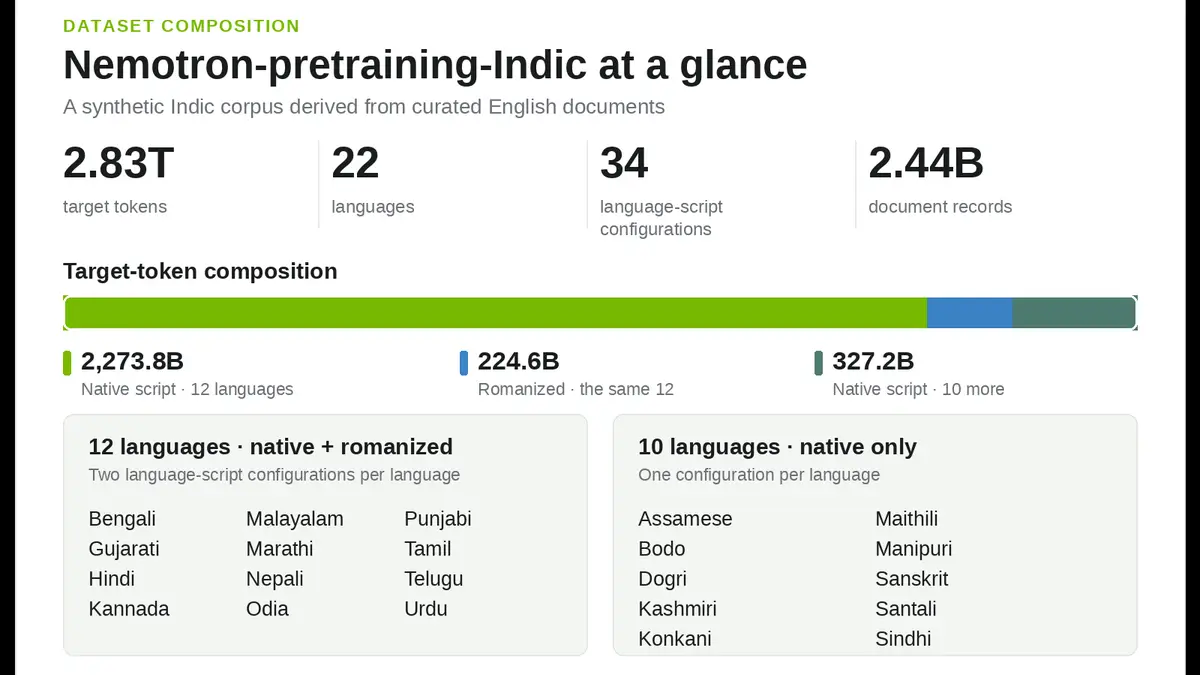
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開 生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
NVIDIA、インド22言語・約2.8兆トークンの事前学習データ「Nemotron(ネモトロン)-pretraining-Indic-v1」を近く公開生成パイプラインもオープンに、IIT Madras・AI4Bharatと共同
研究
Perplexity(パープレキシティ)、Decisions API(ディシジョンズ)に27Bの「pplx-decider-v1.2」と4Bの「flash-v1.2」 入力100万トークン$0.02と$0.01、旧指定はv1.2に自動で切り替わる
Perplexity(パープレキシティ)、Decisions API(ディシジョンズ)に27Bの「pplx-decider-v1.2」と4Bの「flash-v1.2」入力100万トークン$0.02と$0.01、旧指定はv1.2に自動で切り替わる
モデル
Reflection(リフレクション)、初のオープンモデル Beam(ビーム)を公開 総パラメータ501B・アクティブ23B・文脈100万トークンをApache 2.0で、SWE-bench Verified 81.6%は同社提供の数字
Reflection(リフレクション)、初のオープンモデル Beam(ビーム)を公開総パラメータ501B・アクティブ23B・文脈100万トークンをApache 2.0で、SWE-bench Verified 81.6%は同社提供の数字
モデル
Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開 4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
Tencent(テンセント)、AIの長期記憶の「書き込み」専用モデルHy-Memory-30B-A3BをHugging Faceで公開4つの枠組みの平均55.49でClaude Opus 5の54.62を上回ると同社測定
モデル
 動画
Meta「Muse Spark Open(ミューズ スパーク オープン)」公開 公式の表で米国製のInkling・Nemotronを上回り、Kimi K3には20項目中8項目で上回る、Mac Studio 2台で動く
Meta「Muse Spark Open(ミューズ スパーク オープン)」公開公式の表で米国製のInkling・Nemotronを上回り、Kimi K3には20項目中8項目で上回る、Mac Studio 2台で動く
モデル
Apple、MLX(エムエルエックス)とThunderbolt 5のRDMAでMac Studio 4台をつなぎ、816B(8,160億)パラメータのMuse Spark Openを毎秒36トークン超で動かす手順と実測を公開 M5 UltraのTTFTはM3 Ultra比で最大4.6倍
Apple、MLX(エムエルエックス)とThunderbolt 5のRDMAでMac Studio 4台をつなぎ、816B(8,160億)パラメータのMuse Spark Openを毎秒36トークン超で動かす手順と実測を公開M5 UltraのTTFTはM3 Ultra比で最大4.6倍
研究
Apple機械学習研究、AIエージェントの道具探しは「検索が先か、計画が先か」を比較 単純な依頼は検索先、複数ツールの依頼は計画先が上回り、計画先は推論コストが約2倍
Apple機械学習研究、AIエージェントの道具探しは「検索が先か、計画が先か」を比較単純な依頼は検索先、複数ツールの依頼は計画先が上回り、計画先は推論コストが約2倍
研究
Apple機械学習研究、小型検索エージェントの推論を「書く」から「選ぶ」に変える論文SSRを公開 1ターンの推論遅延は90%超減、質問あたりのモデル推論遅延は28〜54%減と著者ら
Apple機械学習研究、小型検索エージェントの推論を「書く」から「選ぶ」に変える論文SSRを公開1ターンの推論遅延は90%超減、質問あたりのモデル推論遅延は28〜54%減と著者ら
研究
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開 8Bと30B、VRAMは基本モデルとほぼ同じと説明
IBM、チャット・判定・音声認識を1つのエンドポイントで扱う「Granite Switch 4.1(グラナイト スイッチ)」を公開8Bと30B、VRAMは基本モデルとほぼ同じと説明
モデル
Microsoft AI、総パラメータ2.8兆のMoE基盤モデル「MAI-Base-2(マイ・ベース・ツー)」の事前学習を完了 DeepSeek-V4-Pro-Baseより4.2〜12.3倍計算効率が高いと主張
Microsoft AI、総パラメータ2.8兆のMoE基盤モデル「MAI-Base-2(マイ・ベース・ツー)」の事前学習を完了DeepSeek-V4-Pro-Baseより4.2〜12.3倍計算効率が高いと主張
モデル
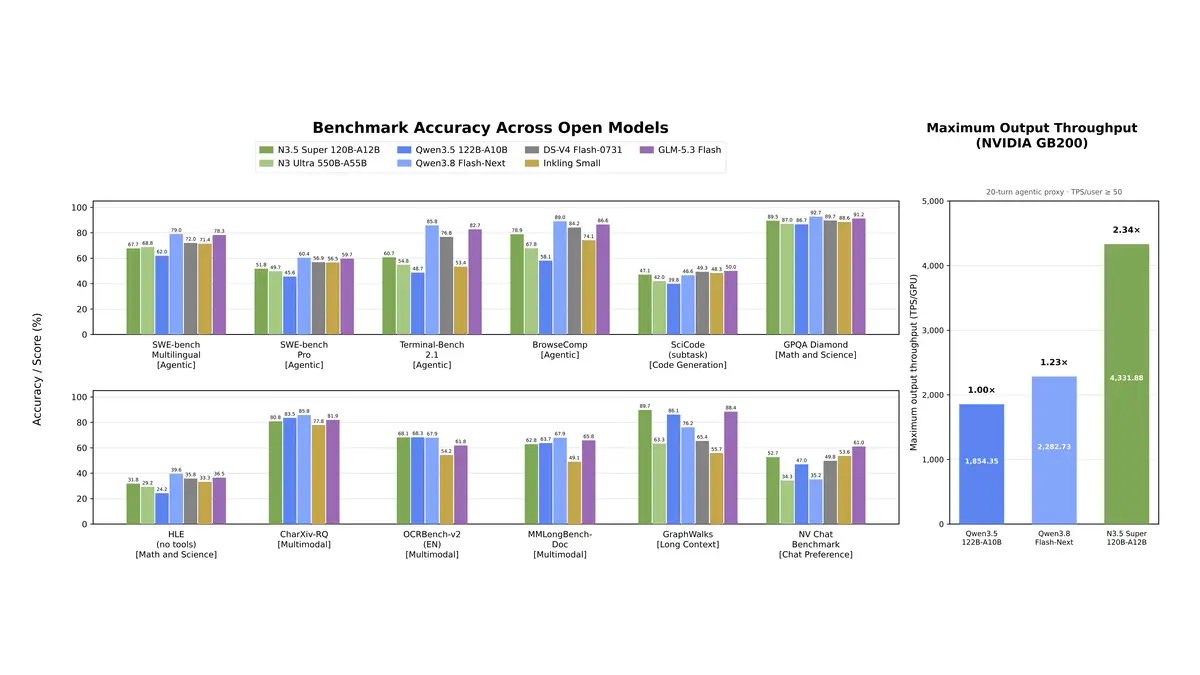
NVIDIA、画像と動画も読む「Nemotron(ネモトロン)3.5 Super VL」を公開 120B・有効12B、公式グラフの首位は12項目中1つで速さはQwen3.5の2.34倍
NVIDIA、画像と動画も読む「Nemotron(ネモトロン)3.5 Super VL」を公開120B・有効12B、公式グラフの首位は12項目中1つで速さはQwen3.5の2.34倍
モデル
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開 8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
Swiss AI Initiative、完全オープンの「Apertus(アペルトゥス)1.5」リリースノートと技術報告書を公開8B・70Bが画像・音声の理解と思考モードに対応、コンテキストは262,144トークン
モデル
判定だけを返すAI「Jev」が1.14に 画像入力・位置を返す「Box」・26万トークンの長文を試験機能で追加、価格は据え置き
判定だけを返すAI「Jev」が1.14に画像入力・位置を返す「Box」・26万トークンの長文を試験機能で追加、価格は据え置き
モデル
Google DeepMindとシンガポール政府技術庁、スマホ内で動く詐欺検知モデルを発表 Gemma(ジェマ)を現地の詐欺会話で微調整、2段階判定で電池消費を抑える
Google DeepMindとシンガポール政府技術庁、スマホ内で動く詐欺検知モデルを発表Gemma(ジェマ)を現地の詐欺会話で微調整、2段階判定で電池消費を抑える
業界
Sakana Chat、覚えているメモリーを見られる新機能「My Fish(マイ・フィッシュ)」を追加 一覧・つながりマップ・履歴の3画面、設定→My Fishから
Sakana Chat、覚えているメモリーを見られる新機能「My Fish(マイ・フィッシュ)」を追加一覧・つながりマップ・履歴の3画面、設定→My Fishから
プロダクト
 動画
Google、Gemini 4 Argon(ジェミニ4 アルゴン)を世界で一般提供 API・Geminiアプリ・AIモードで、導入価格は入力$2・出力$10(100万トークンあたり)
Google、Gemini 4 Argon(ジェミニ4 アルゴン)を世界で一般提供API・Geminiアプリ・AIモードで、導入価格は入力$2・出力$10(100万トークンあたり)
モデル