Google、A2UI(エーツーユーアイ)に出力形式の差し替え機能と新既定「A2UI Express(エクスプレス)」生成UIの遅延は最大3倍短縮、決定モデル併用で最大80倍と発表
日刊AIニュース10月27日(火)号:前日のAIのニュース12本を短くまとめました(約8分)›
Googleは10月27日、エージェントが画面を作るプロトコルA2UIに、モデルが出力する形式を選べる「swappable inference formats」を追加した。新既定のA2UI Expressはトークン数が最大3分の1、遅延は最大3倍短縮と同社は説明している。
目次
Googleは2026年10月27日(現地)、エージェントが画面を生成するためのプロトコル「A2UI(エーツーユーアイ)」に、モデルが出力する形式を差し替えられる「swappable inference formats」と、新しい既定の形式「A2UI Express(エクスプレス)」を追加したと、Google Developers Blogで発表した。同社は、Expressを使うと遅延を最大3倍短縮でき、同じ種類のUIを作るのに必要なトークンは従来のDirect JSONの最大3分の1になると説明している。レイアウトを決定モデル「Jev」に選ばせる方式では、最大80倍の短縮とうたう。
3行まとめ
- Googleは10月27日、A2UIに出力形式を差し替える仕組みと新既定「A2UI Express」を追加。Pythonは a2ui-agent-sdk 0.9.0、TypeScriptは @a2ui/agent、Dartは a2ui_agent 0.0.1-wip004 で使える(同社ブログ)。
- 同社の説明では、Expressは遅延が最大3倍短縮・トークン数が最大3分の1。決定モデルJevでレイアウトを決める方式は最大80倍。
- Jev方式はSDKに未搭載で、オープンソースのApparite(jev2ui)が例。11プロンプトの1回の実行では、各画面は0.8〜1.7秒で完成したが、同プロジェクトも「最初の目安」としている。
本記事の内容は、日本時間10月28日0時台に公式ページで確認したものです。
A2UI Expressで何が変わるのか
A2UIは、Googleのブログによると「エージェント向けに最適化された生成UIのプロトコル」だ。クライアントが信頼できる部品のカタログを約束事として提示し、エージェントがそのカタログの部品で組んだ画面をA2UIメッセージで送り、クライアントのレンダラーが描く。
ブログによれば、これまではエージェントがA2UIのJSONメッセージを、波括弧の一つひとつまで直接生成していた。同社は、複雑なJSONスキーマに縛られたJSONの木を生成するのはLLMにとって遅く間違えやすいと説明している。そこで今回、モデルが出すものと、クライアントに送るものを分けた。
- モデルは中間形式(A2UI Express)を出力する
- SDKの決まった処理(コンパイラ)が、それをJSONベースの送信用プロトコルに変換する
- 別のDSLとそのコンパイラに差し替えることもできる
モデルが生成する形式は inference_format と呼ばれ、ジェネレーターを作るときの引数1つで指定する。SDKは、カタログのJSONスキーマから、その形式用のプロンプト指示と、モデルの返答を検証済みのA2UIメッセージにするコンパイラの両方を作る。ブログは、どちらもスキーマから作られるので、カタログにない部品や属性を形式が表現することはない、と説明している。
Expressはどんな書き方か
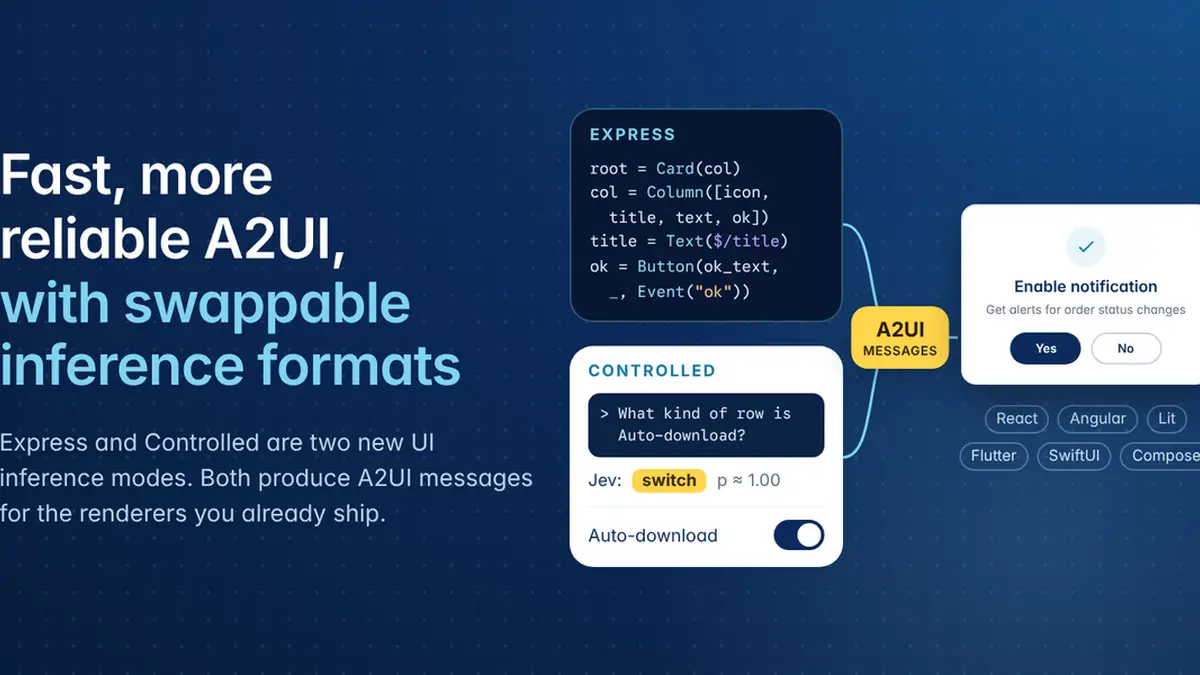
Expressは1行に1文で、Pythonに近い書き方だ。各行が部品を変数に代入し、変数名が部品IDになる。引数は位置で渡し、コンパイラがカタログスキーマの宣言順にプロパティ名へ対応づける。_ は1つ飛ばす記号だ。ブログが示すA2UIギャラリーの通知カードは次のとおり。
surface("gallery-notification-permission")
$/description="Get alerts for order status changes"
$/icon="check"
$/title="Enable notification"
root=Card(main_column)
main_column=Column([icon, title, description, actions], _, "center")
icon=Icon($/icon)
title=Text($/title)
description=Text($/description, "body")
actions=Row([yes_btn, no_btn], "center")
yes_btn_text=Text("Yes")
yes_btn=Button(yes_btn_text, _, Event("accept", {}))
no_btn_text=Text("No")
no_btn=Button(no_btn_text, _, Event("decline", {}))
Pythonのエージェント SDKでは、Expressはマクロとも併用できる。ブログの例では、モデルは OrderStatus("ord_42") のようにIDだけを書き、マクロが注文を取得して値を埋める。画面の値はすべて自社データから来る、という使い方だ。
どのSDKで、どう使うのか
| SDK | パッケージ(ブログ記載) |
|---|---|
| Python | a2ui-agent-sdk 0.9.0(PyPI) |
| TypeScript | @a2ui/agent(npm) |
| Dart | a2ui_agent 0.0.1-wip004(pub.dev) |
使い方はブログによると、pip install a2ui-agent-sdk または npm install @a2ui/agent で入れ、ジェネレーター作成時に ExpressFormatFactory() を渡し、モデルは思考(thinking)をオフにして動かす。TypeScriptでは new ExpressFormatFactory() をジェネレーターの3番目の引数に渡す。カタログとレンダラーはそのまま使える。
PythonとTypeScriptのSDKは、Direct JSONをチャンクごとにストリーミングできるが、Expressは返答が全部そろってからコンパイルする、とブログは書いている。一方、Expressの仕様ページは、行単位の文法のおかげで、モデルの出力が終わる前に段階的に描画できると説明している。両者の記述は並べて読む必要がある。
Gemini(ジェミニ)などスキルを読み込むモデルにExpressを教えるため、Python SDKの SkillGenerator でカタログからスキルを生成する方法もブログに載っている。
数字はどう出たのか
ブログによると、Googleは4つの形式を試した。
| 形式 | 内容(ブログの説明) |
|---|---|
| Direct JSON | 2025年12月の公開時からのベースライン |
| Express | Pythonに着想を得た形式。新しい既定に採用 |
| Atom | Lisp風のS式。代入も閉じタグもない |
| Elemental | カスタム要素のHTML。モデルがHTMLを書く力に賭ける |
同じ51課題の評価を gemini-3.5-flash で、思考オンとオフの両方で比べた。Googleは、Expressは思考オフでも同じようにうまく動き、そのときが最速の推論になると書いている。
仕様ページには、トークン削減の別の表現がある。構造のキーや括弧、繰り返しの引用符を省くため、A2UIの標準ペイロードに比べて出力トークンが55〜70%減る、という記述だ。ブログの「最大3分の1」とは基準の語が違い(Direct JSONと標準ペイロード)、本記事では両方を併記するにとどめる。
決定モデルJevはどう使うのか
設定画面、チェックアウト、確認画面のように形が決まっている画面では、モデルがレイアウトを設計する必要はなく、用意済みのレイアウトから選べばよい、とブログは説明する。そのために紹介されているのが、TypeSafe社のJevだ。
ブログによると、Jevは「System One model」、つまり速い構造化された判断を出すモデルで、文章やJSONは作らない。状態と型付きの質問を送ると、各質問に確率で答える。質問は、文が真か(Noul)、選択肢のどれが合うか(Choice)、ルーブリックでの点数(Score)の3種類。1回のリクエストで多数の質問に答え、所要はおよそ100〜300msという。
この方式の例が、オープンソースのデザインツール Apparite(jev2ui)だ。
- Jevの1リクエストで、文法が定めるレイアウトの質問(1画面で約30問)に答える
- コードがカタログから部品の木を組み、
createSurfaceとupdateComponentsを約200msで送る。文章が入る場所はプレースホルダー - gemini-3.5-flash-lite が文章だけを
updateDataModelに流し込む。部分が届くごとに、依存する判断を小さなJevリクエストで決める
質問はMarkdownの文法ファイルに事前に書いておく。ブロック引用が質問、箇条書きが選択肢と基準になる。ブログの例では、ポッドキャストアプリの設定画面で Skip forward → value、Auto-download → switch、Log out → danger と、それぞれp ≈ 1.00で答えた。
11プロンプトの1回の実行では、部品の木が画面に出るまで92〜298ms、各画面の完成まで0.8〜1.7秒だった。文章を書く側の出力は1画面あたり101〜341トークンで、AppariteのJevパイプライン2本は11プロンプトすべてで有効なA2UIを出した。ブログは、サンプルが小さいため、プロジェクトはこの数字を「最初の目安」と扱っている、と明記している。
どのモードを選ぶのか
ブログの整理は次のとおり。
- Controlled(決定モデル): 画面が決まったレイアウトに沿うなら、最速になりうる
- Express: カタログに基づく表現力が必要な画面。モデルが部品の木を全部書く
- 独自の形式: 新しい用途向けに、DSLを教えるプロンプト生成器と、DSLとA2UIメッセージの変換器を用意すれば、カタログとレンダラーはそのまま
日本の開発者にとっての位置づけ
今回確認した公式ページには、日本向けの提供条件や料金の記載はなかった。対象はSDKとオープンな仕様で、Pythonの pip とTypeScriptの npm から入れる形だ。Jevの利用条件や料金については、ブログが参照先に挙げるTypeSafeの資料を本記事では確認していない。
公式ページを見て気づいたこと
日本時間0時台に取得したブログの出典欄には、a2ui-agent-sdkの変更履歴が「0.9.0、2026年10月17日」と書かれていた。変更履歴のページを開くと、0.9.0は確かに2026-10-17の項目で、Expressが a2ui.inference_formats.experimental.express から a2ui.inference_formats.express へ移された変更が載っていた。変更履歴の日付の上では、Expressを正式な場所に置いた版はブログの10日前に記録されている(PyPIでの公開日は本記事では確かめていない)。
一方で、同じ変更履歴の「Unreleased(未リリース)」欄には、A2uiGenerator と A2uiRequestProcessor の既定を DirectJsonFormatFactory から ExpressFormatFactory に変える変更が「BREAKING」として載っていた。ブログはExpressを「新しい既定」と書いているが、Python SDKで既定が切り替わる変更は、取得時点の変更履歴では0.9.0ではなく未リリースの欄にある。0.9.0を入れて使う場合は、ブログの手順どおり ExpressFormatFactory() を明示して渡すのが確実だ。
もう1つ、ブログの出典欄ではnpmの @a2ui/agent は「0.0.1」と書かれている。Pythonの0.9.0とはバージョンの数字が大きく違う。この数字の差が何を意味するのか、取得したページには説明がなかった。
「80倍」の基準と、SDKの版で残る疑問
- 「最大80倍」の基準: ブログの冒頭に出てくるだけで、何と比べた数字かの説明は、取得したブログ本文では見つけられなかった。AppariteのREADMEの「Results so far」には、Geminiに画面を丸ごと書かせる「Baseline」が最初の部品送信・完成ともに2.8〜6.7秒、Jev方式の最初の部品送信が92〜298msという表がある。ただし、これが「80倍」の根拠かどうかはどちらのページにも書かれていない
- 「最大3倍」も上限値: 51課題の評価は gemini-3.5-flash で行われたもので、ブログには個別の表やグラフの数値は載っていなかった(本記事の取得テキスト上)
- Jev方式はSDK未搭載: ブログは、A2UI Agent SDKに決定モデルの推論フォーマットはまだない、Apparite(jev2ui)はあくまで組み立て方の例だと書いている。また、決定モデルで作れるのは文法が記述するレイアウトだけで、Appariteの文法は9種類の画面原型と12のブロックを扱う
- Dartはv1.0未対応: Expressの仕様ページには、複数カタログの挙動はPythonとTypeScriptのSDKで実装されており、Dart版のExpressコンパイラはまだv1.0に対応していない、との注記がある。Dart SDKのバージョンは
0.0.1-wip004と記載されている - 仕様ページはv0.9.1が現行表示: 取得した仕様ページのナビゲーションでは v0.9.1 が「Current」だが、Expressの本文は主にA2UI v1.0のペイロードへの変換を説明している(v0.9・v0.9.1向けの出力や、そこでできない操作についての記述もある)。使うプロトコル版での挙動は仕様ページで確認が必要だ
- 筆者はA2UI SDKを実行しておらず、速度やトークン数は再現していない。数字はすべてGoogleとプロジェクトの記載による
突き合わせた4つのページ
- Fast, reliable A2UI, with swappable inference formats — Google Developers Blog(日本時間2026年10月28日0時22分取得)
- A2UI Express technical specification(同0時22分取得)
- a2ui_agent CHANGELOG(GitHub)
- dglazkov/jev2ui(Apparite)
本記事は続報があり次第更新します。
この記事でよく聞かれること
- A2UI Expressとは何ですか?
- Googleが2026年10月27日に発表した、A2UIでモデルが出力する中間形式です。1行に1つの文で、Pythonに近い書き方で部品を並べます。SDKの決まった処理(コンパイラ)がこれをA2UIのJSONメッセージに変換します。同社は、Direct JSONと比べて同じ種類のUIを作るのに必要なトークンが最大3分の1、遅延は最大3倍短縮できると説明しています。
- A2UI ExpressはどのSDKで使えますか?
- Googleのブログによると、Pythonのエージェント SDK(PyPIのa2ui-agent-sdk 0.9.0)、TypeScriptのエージェントSDK(npmの@a2ui/agent)、Dart SDK(pub.devのa2ui_agent 0.0.1-wip004)で使えます。A2UI Expressの仕様ページには、Dart版のExpressコンパイラはv1.0にまだ対応していないとの注記があります。
- 決定モデルJevを使うと何が変わりますか?
- ブログによると、Jevは文章やJSONを作らず、状態と型付きの質問を受けて確率で答えるモデルで、1回のリクエストで多数の質問に約100〜300msで答えます。レイアウトを事前に決められる画面では、これでA2UIの構造を決めると最大80倍速くなるとGoogleは説明しています。ただしA2UI Agent SDKにJev用の推論フォーマットはまだ含まれておらず、オープンソースのApparite(jev2ui)が組み立て方の例として示されています。
出典・参照資料
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
Google、Gemini 4 Argon(ジェミニ4 アルゴン)に11時間の無人実行でADKを最適化させ、長いセッションの前処理を約40%短縮 6案のうち採用は2案
Google、Gemini 4 Argon(ジェミニ4 アルゴン)に11時間の無人実行でADKを最適化させ、長いセッションの前処理を約40%短縮6案のうち採用は2案
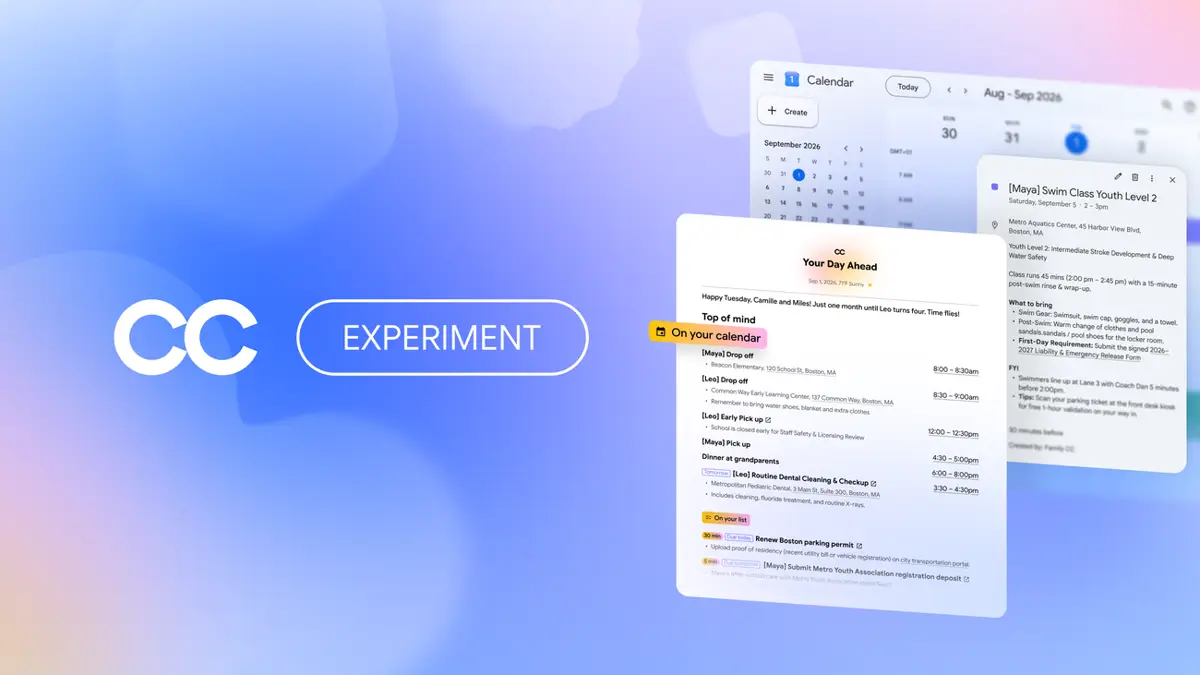
Google Labsの個人エージェント「CC」が家族向けに CC自身が検証済みのGoogleアカウントを持ち、最大6人が共有。各人が選んだメール(学校・スイミング・動物病院)だけを読み、毎朝の共有ブリーフ、カレンダーとタスクの自動更新、許可を得て申込書PDFの記入や献立作成。隔離クラウドでAntigravityと最新Gemini。米国18歳以上、待機リスト
Google Labsの個人エージェント「CC」が家族向けにCC自身が検証済みのGoogleアカウントを持ち、最大6人が共有。各人が選んだメール(学校・スイミング・動物病院)だけを読み、毎朝の共有ブリーフ、カレンダーとタスクの自動更新、許可を得て申込書PDFの記入や献立作成。隔離クラウドでAntigravityと最新Gemini。米国18歳以上、待機リスト
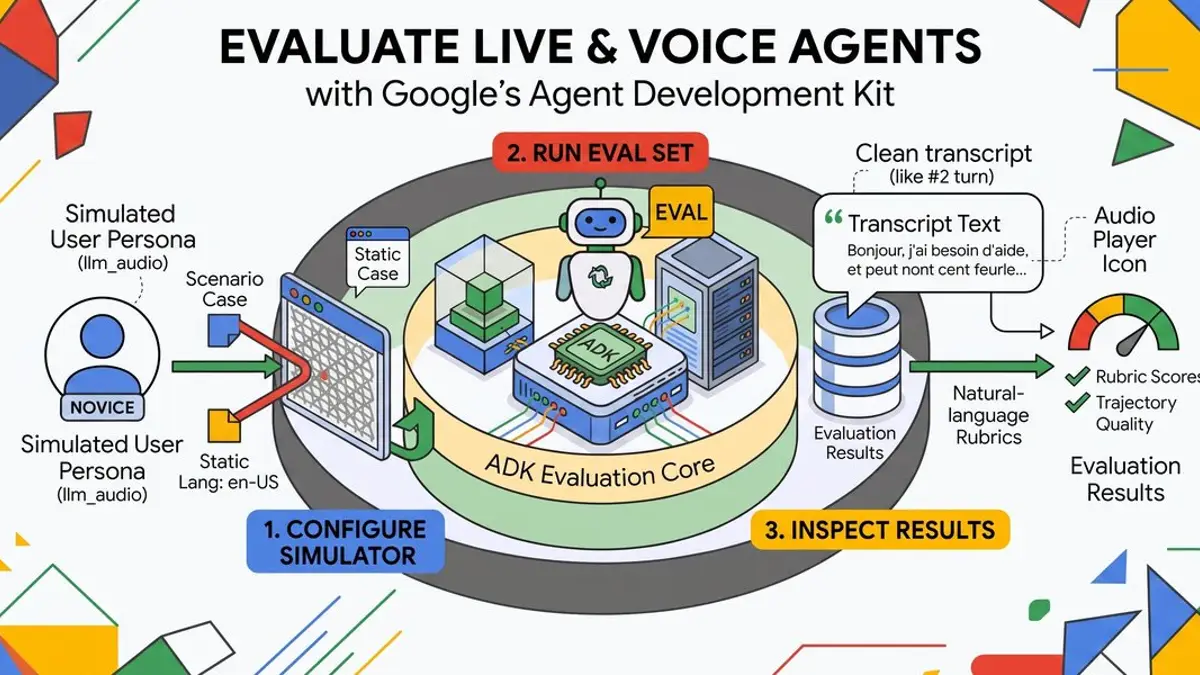
Google ADKに「ライブ・音声エージェントの評価」 模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
Google ADKに「ライブ・音声エージェントの評価」模擬ユーザーがGemini TTSで話し、音声の返答をルーブリックで採点。名前確認→生年月日の検証(ツール呼び出し)→予約案内の3段ワークフローを、会話計画とペルソナ(NOVICE等)で即興させるか台本どおりに回す。test_config.jsonのlive_model_configを外せば同じケースをテキストで実行、CI/CDにも
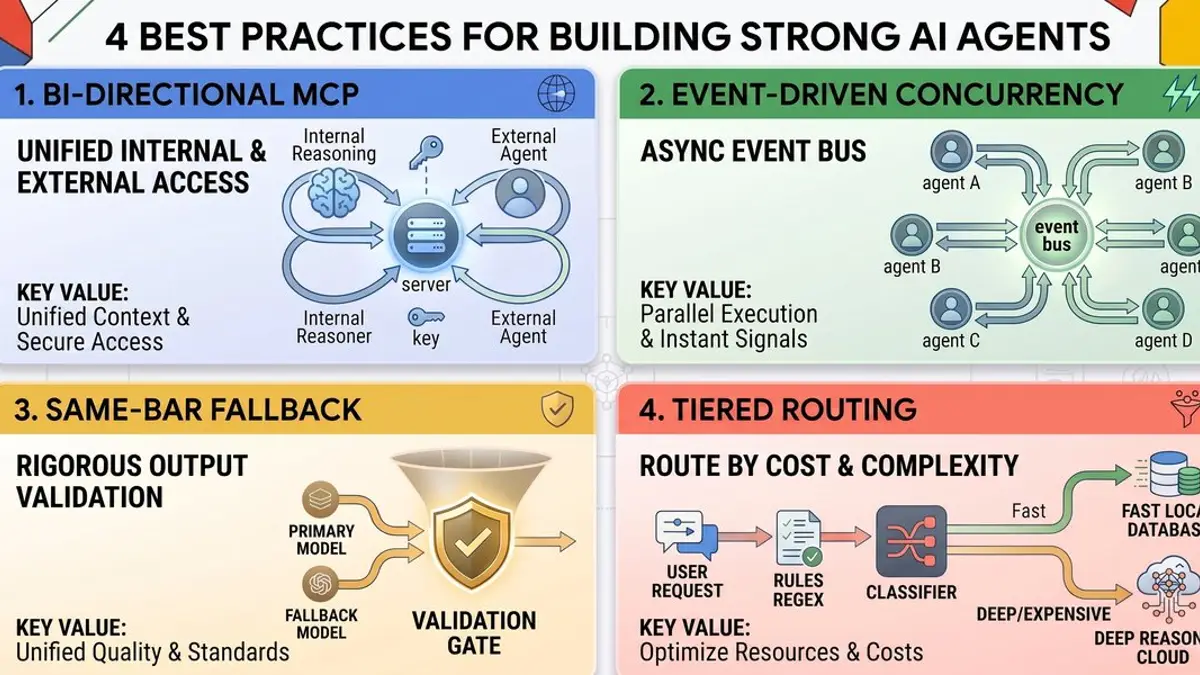
Google「AI Agents Challenge」上位に共通した4つの設計 ①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Google「AI Agents Challenge」上位に共通した4つの設計①自分のツール層をMCPサーバーとして他のエージェントにも開く②呼び出し連鎖でなくイベントバスで並列に反応③フォールバック先のFlashも同じ検証関数を通す④正規表現→10トークンの分類→本モデルの3層で4割超をモデル呼び出し前に処理。「名前つきプロンプトの連鎖」は多エージェントではない
Google DeepMind「クライアントSDKの生成はオープンであるべき」 2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守
Google DeepMind「クライアントSDKの生成はオープンであるべき」2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守
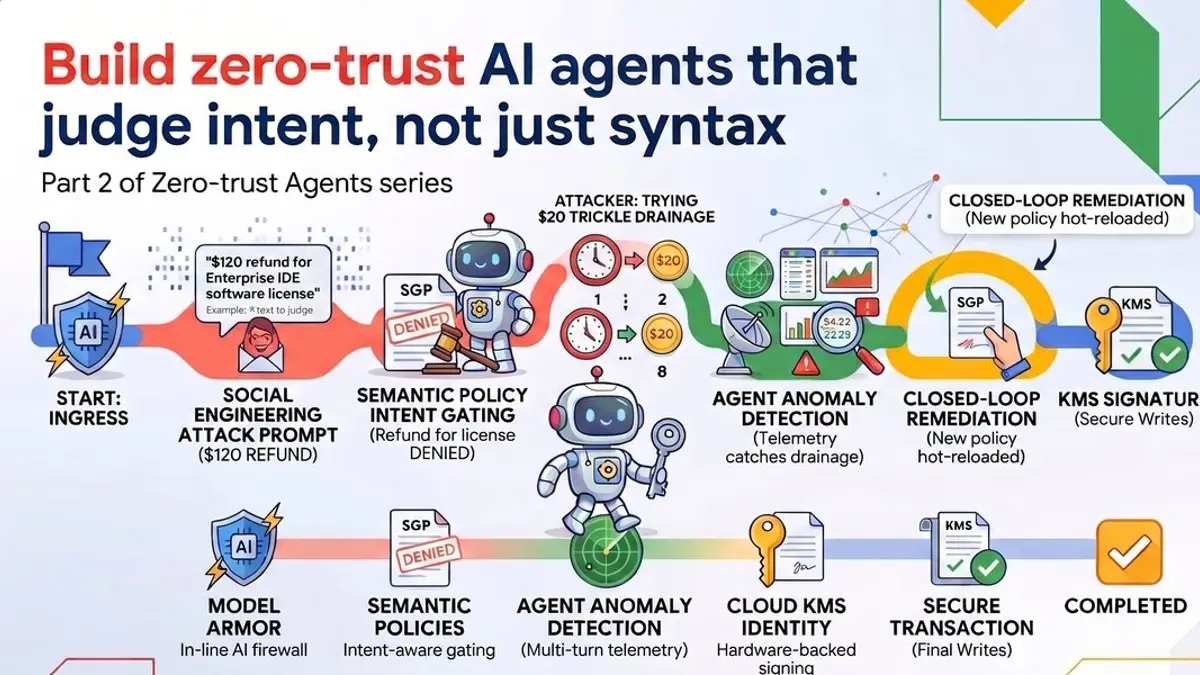
Google「ゼロトラスト・エージェント」第2回 構文でなく意図を判定する。正規表現の脱獄辞書をModel Armor(入口で403)に、「30ドル超のソフトライセンスは返金不可」を自然言語のポリシー(1判定2,576トークン)に、20ドル×8回で160ドルを抜く多ターン攻撃をAgent Anomaly Detectionに置き換え、再デプロイなしで新ポリシーを足して閉じる
Google「ゼロトラスト・エージェント」第2回構文でなく意図を判定する。正規表現の脱獄辞書をModel Armor(入口で403)に、「30ドル超のソフトライセンスは返金不可」を自然言語のポリシー(1判定2,576トークン)に、20ドル×8回で160ドルを抜く多ターン攻撃をAgent Anomaly Detectionに置き換え、再デプロイなしで新ポリシーを足して閉じる
Gemini「エージェント型の動画理解」 毎秒1フレームで丸ごと読む代わりに、必要な区間だけ探して見直す。トークン最大88%減・費用最大66%減・精度最大7%向上(Google DeepMind、3.7 Flash・3.6 Flash・3.5 Flash-Lite)。APIの設定を"agentic"にするだけ、追加料金なし。Geminiアプリと「Ask YouTube」にも順次
Gemini「エージェント型の動画理解」毎秒1フレームで丸ごと読む代わりに、必要な区間だけ探して見直す。トークン最大88%減・費用最大66%減・精度最大7%向上(Google DeepMind、3.7 Flash・3.6 Flash・3.5 Flash-Lite)。APIの設定を"agentic"にするだけ、追加料金なし。Geminiアプリと「Ask YouTube」にも順次