オープンソース・オープンウェイトの記事
「オープンソース・オープンウェイト」に関連するAIニュースと解説、247本。新しい順に並べています。
オープンソース・オープンウェイト の記事:247件
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
検証
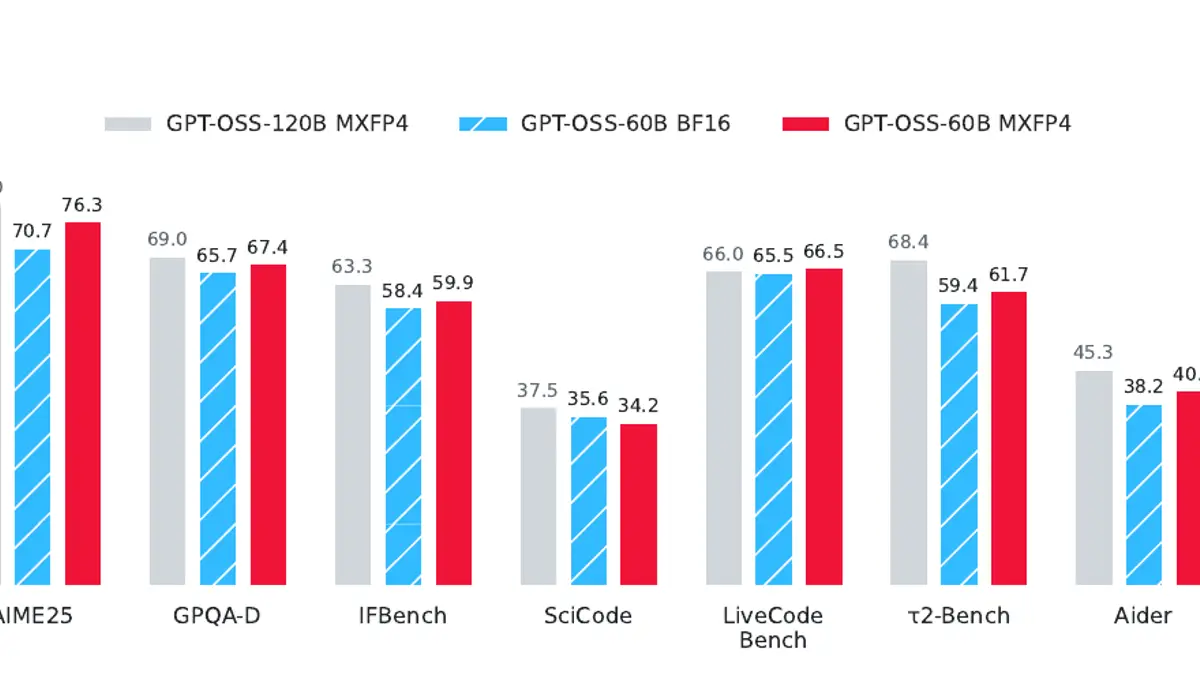
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
検証
Ai2「BenchMIRT」 100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)
Ai2「BenchMIRT」100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)
検証
H Company「NeoMME」 画像パッチとテキストを1つの双方向Transformerで処理する260M・800Mの多言語マルチモーダルエンコーダ(Apache 2.0)。事前学習の視覚塔も言語モデルも使わずマスク離散拡散でゼロから学習。文書検索版はViDoRe v3で260Mが0.523(ColQwen2.5の14分の1のパラメータ)、索引は1ページ1.5MB→6kB(255分の1)
H Company「NeoMME」画像パッチとテキストを1つの双方向Transformerで処理する260M・800Mの多言語マルチモーダルエンコーダ(Apache 2.0)。事前学習の視覚塔も言語モデルも使わずマスク離散拡散でゼロから学習。文書検索版はViDoRe v3で260Mが0.523(ColQwen2.5の14分の1のパラメータ)、索引は1ページ1.5MB→6kB(255分の1)
検証
Hugging Face「funes」 Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
Hugging Face「funes」Claude Code・Codex・pi・Hermesのセッション記録を1つの記憶にする単一バイナリ。`funes add claude`でエージェントにrecallとgetのツールが付き、完了したターンごとに自動で索引。埋め込みと再ランクは手元で動き、共有したければ自分のHugging Faceデータセット(既定で非公開)に。要約せず原文と出所を返す
検証
Hugging Face、ICML 2026の論文をコーディングエージェントで再現するハッカソン 19日間で1,221人が6,816本の記録を公開し2,226本(会議の34%)を試み、35,908の主張を判定。51%で少なくとも1つの主張が検証、23%で少なくとも1つが反証または係争、242本は独立チームが正反対の判定。スポットライト論文の定理が崩れ、著者は当日確認
Hugging Face、ICML 2026の論文をコーディングエージェントで再現するハッカソン19日間で1,221人が6,816本の記録を公開し2,226本(会議の34%)を試み、35,908の主張を判定。51%で少なくとも1つの主張が検証、23%で少なくとも1つが反証または係争、242本は独立チームが正反対の判定。スポットライト論文の定理が崩れ、著者は当日確認
検証
Hugging Face「オープンモデルの現状・2026年夏」 中国ラボの月間最大モデル(754B〜2.78T)がほぼ毎月米国を上回る、米国で最多公開はAMDとNVIDIA、ダウンロード上位25と「いいね」上位25の重なりは1本だけ、Qwenの派生は151,448本で1日180〜210本、Hubを叩くエージェントはClaude Codeが7月44.4%・Codexが20.8%
Hugging Face「オープンモデルの現状・2026年夏」中国ラボの月間最大モデル(754B〜2.78T)がほぼ毎月米国を上回る、米国で最多公開はAMDとNVIDIA、ダウンロード上位25と「いいね」上位25の重なりは1本だけ、Qwenの派生は151,448本で1日180〜210本、Hubを叩くエージェントはClaude Codeが7月44.4%・Codexが20.8%
検証
Hugging Face「@huggingface/kernels」 ブラウザ推論の土台として、207本のWebGPUカーネルを1本ずつ版つきリポジトリ(契約・WGSLテンプレート・正当性テスト・ベンチマーク)としてHubで公開(Apache 2.0)。`getKernel`でHubから直接読み込み、「Fleet」で来訪者のGPUでの正当性と速度の証拠を同意のうえで集める
Hugging Face「@huggingface/kernels」ブラウザ推論の土台として、207本のWebGPUカーネルを1本ずつ版つきリポジトリ(契約・WGSLテンプレート・正当性テスト・ベンチマーク)としてHubで公開(Apache 2.0)。`getKernel`でHubから直接読み込み、「Fleet」で来訪者のGPUでの正当性と速度の証拠を同意のうえで集める
検証
IBM「Granite 4.2」の作り方 初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
IBM「Granite 4.2」の作り方初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
検証
NVIDIA「Magpie TTS Multilingual」 3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
NVIDIA「Magpie TTS Multilingual」3億6,400万パラメータのオープンウェイト音声合成が日本語を含む12言語(新たにアラビア語・韓国語・ブラジルポルトガル語)、各言語に男女の話者、日本語の混在発音と発音辞書に対応。自社基盤で動かし、最初の音声までB200で32ms・H100で47ms・DGX Sparkで53ms、64並列でも実時間の320倍
検証
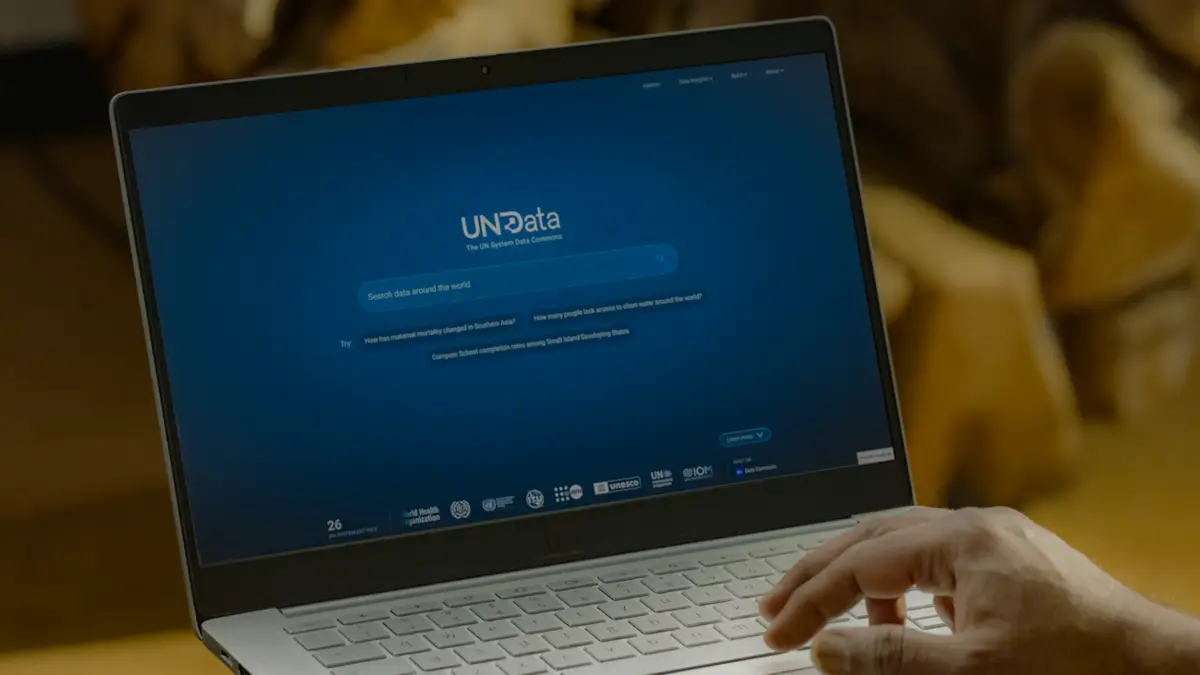
国連システムが「UN System Data Commons」を公開 GoogleのData Commonsを土台に、各機関で形式の違った統計を1つのAI対応の知識グラフに統合。自然言語で「農村の水へのアクセスは就学率にどう影響するか」と聞けば図表が返り、MCPでAIエージェントが公式数値を直接取得。2027年までに国連統計データセットの80%を収録
国連システムが「UN System Data Commons」を公開GoogleのData Commonsを土台に、各機関で形式の違った統計を1つのAI対応の知識グラフに統合。自然言語で「農村の水へのアクセスは就学率にどう影響するか」と聞けば図表が返り、MCPでAIエージェントが公式数値を直接取得。2027年までに国連統計データセットの80%を収録
検証
CrowdStrikeとNVIDIA「SafeMind」 攻撃側と防御側のAIが同じ環境で互いに挑み合う「共進化ループ」を製品に。防御モデルはオープンなNemotronを脅威データで追加学習(Nemotron 3 Ultraが指揮)、社内評価では最前線モデルより高精度で費用99%減。NVIDIA自社ネットワークのデジタルツインで赤・青を対戦。AI攻撃は前年比89%増、最速侵入27秒
CrowdStrikeとNVIDIA「SafeMind」攻撃側と防御側のAIが同じ環境で互いに挑み合う「共進化ループ」を製品に。防御モデルはオープンなNemotronを脅威データで追加学習(Nemotron 3 Ultraが指揮)、社内評価では最前線モデルより高精度で費用99%減。NVIDIA自社ネットワークのデジタルツインで赤・青を対戦。AI攻撃は前年比89%増、最速侵入27秒
検証
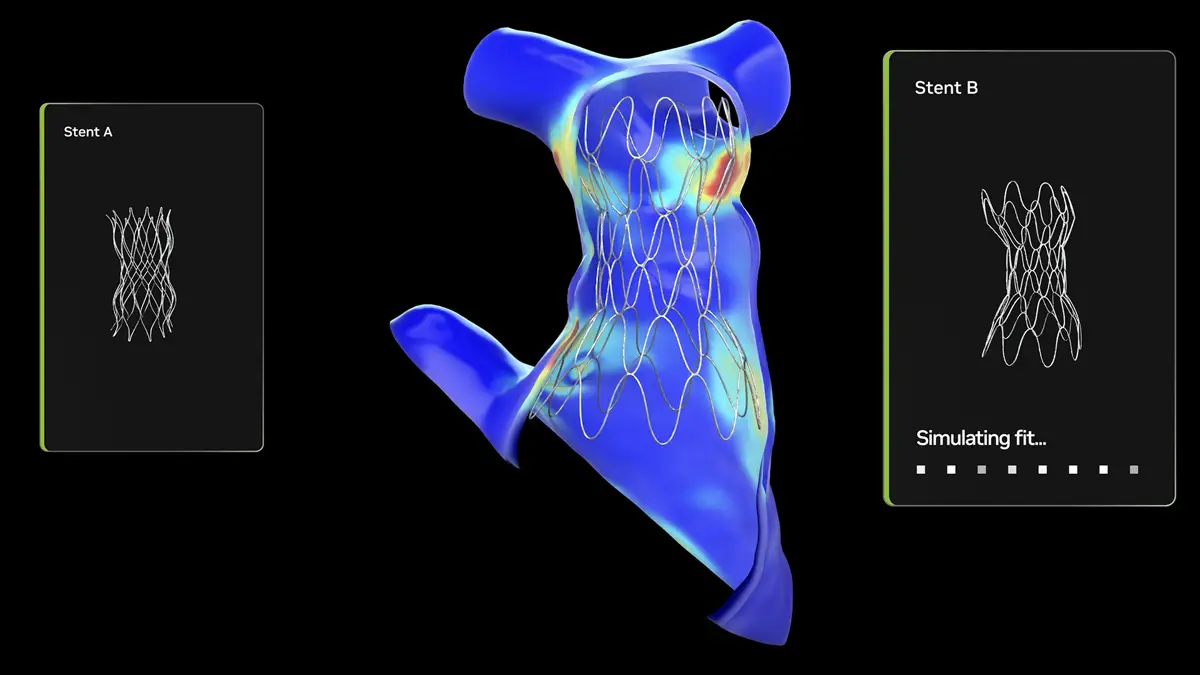
フィラデルフィア小児病院、オープンソースのNVIDIA AIで子どもの心臓を数秒でモデル化 MONAI Label+Auto3DSegで、熟練研究者が4時間かけていたCT・MRI・3D超音波からの心臓模型作りを数秒に。米国20超の小児病院が心臓モデリング、ボストン小児は年約500例。NewtonとWarpで機器を入れた時の挙動を最大4時間→ほぼリアルタイムに
フィラデルフィア小児病院、オープンソースのNVIDIA AIで子どもの心臓を数秒でモデル化MONAI Label+Auto3DSegで、熟練研究者が4時間かけていたCT・MRI・3D超音波からの心臓模型作りを数秒に。米国20超の小児病院が心臓モデリング、ボストン小児は年約500例。NewtonとWarpで機器を入れた時の挙動を最大4時間→ほぼリアルタイムに
検証
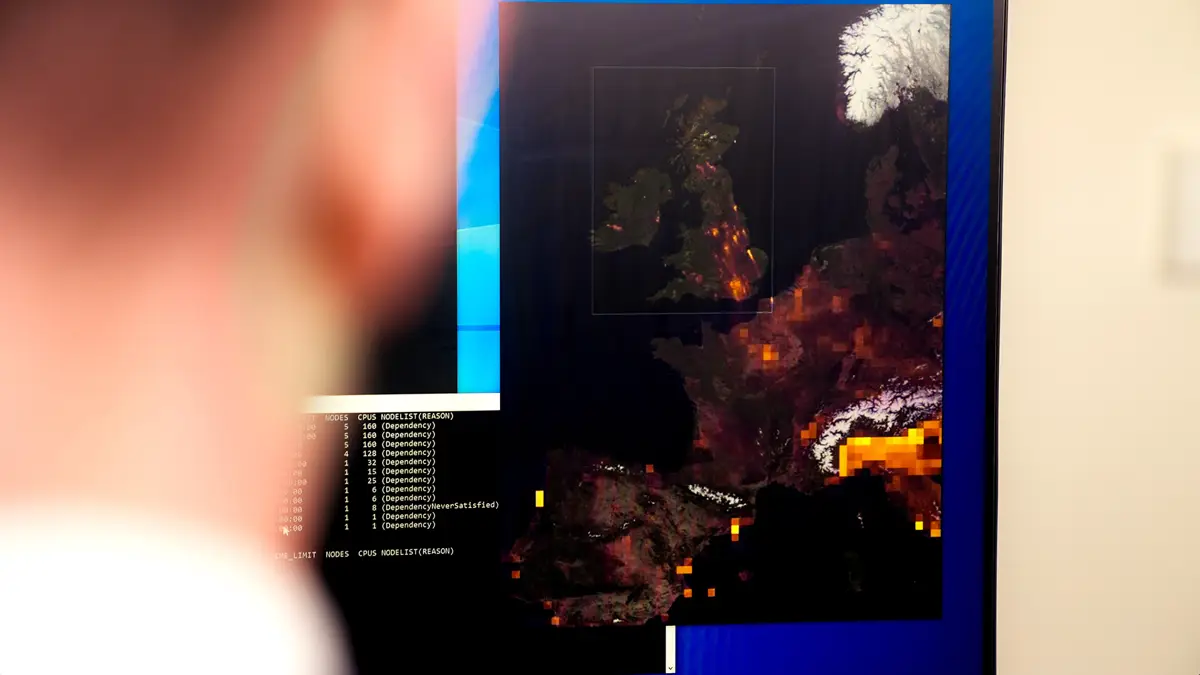
マンチェスター大学、NVIDIA Earth-2で英国全土の大気汚染モデル 天気予報用の生成モデルCorrDiffを汚染場に転用。1年分・毎時の模擬データで2〜3km格子の全土モデルを、国のAIスパコンIsambard-AIの8GPU 1ノードで2日で学習、初回で動作。推論と再学習は机上のDGX Sparkで。学習データと手順を公開予定
マンチェスター大学、NVIDIA Earth-2で英国全土の大気汚染モデル天気予報用の生成モデルCorrDiffを汚染場に転用。1年分・毎時の模擬データで2〜3km格子の全土モデルを、国のAIスパコンIsambard-AIの8GPU 1ノードで2日で学習、初回で動作。推論と再学習は机上のDGX Sparkで。学習データと手順を公開予定
検証
NVIDIA、IFA 2026でローカルAIの4本 Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC
NVIDIA、IFA 2026でローカルAIの4本Hermes Agent・OpenClaw・Perplexity Portable Computerがワンクリックでローカルモデル設定、llama.cppはRTX 5090で最大1.9倍、家庭内の遊休PCに推論を振り分ける無料OSS「PAIR」(Apple M4以降も)、10月にRTX Spark搭載Windows PC
検証
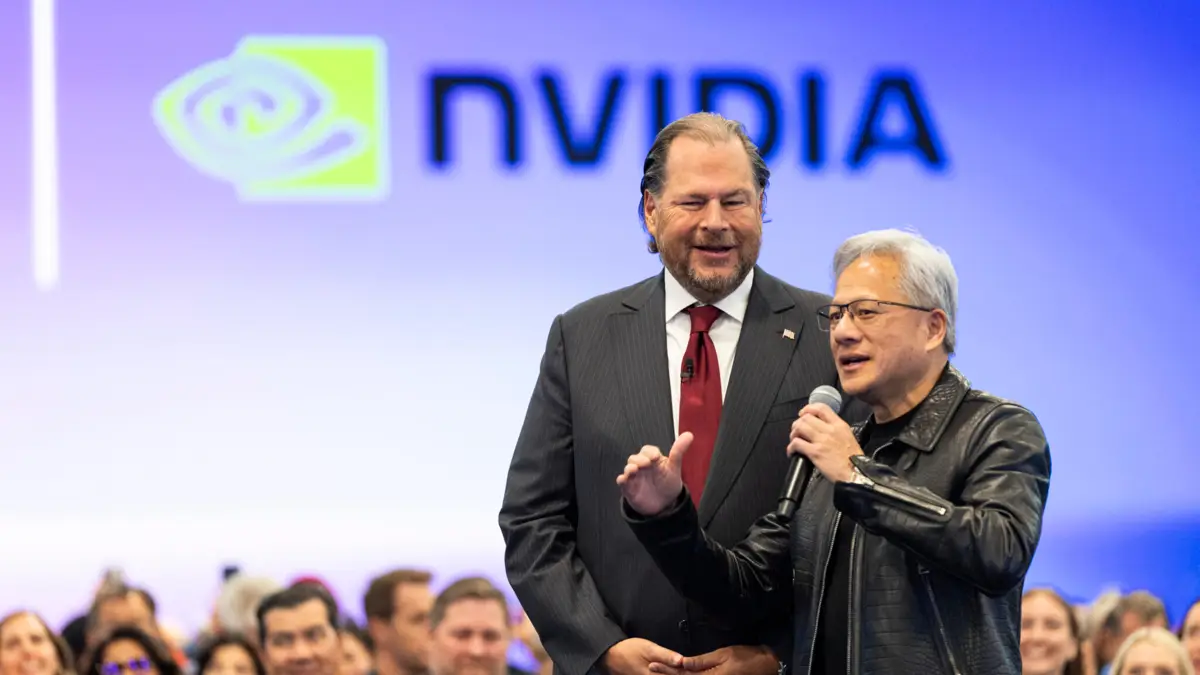
Salesforce初のCRM推論モデル「Koa」 NVIDIA Nemotron 3 Superを約30年分のCRM展開から作った合成データで追加学習(顧客データは「1バイトも」使わず)、重みは自社が保持。CRM Benchで主要モデルと同等以上、誤りは3分の1。10月にF1・Xeroなどで顧客パイロット、冬に米国で一般提供。Huang氏「速さと安全は偽の二択」
Salesforce初のCRM推論モデル「Koa」NVIDIA Nemotron 3 Superを約30年分のCRM展開から作った合成データで追加学習(顧客データは「1バイトも」使わず)、重みは自社が保持。CRM Benchで主要モデルと同等以上、誤りは3分の1。10月にF1・Xeroなどで顧客パイロット、冬に米国で一般提供。Huang氏「速さと安全は偽の二択」
検証
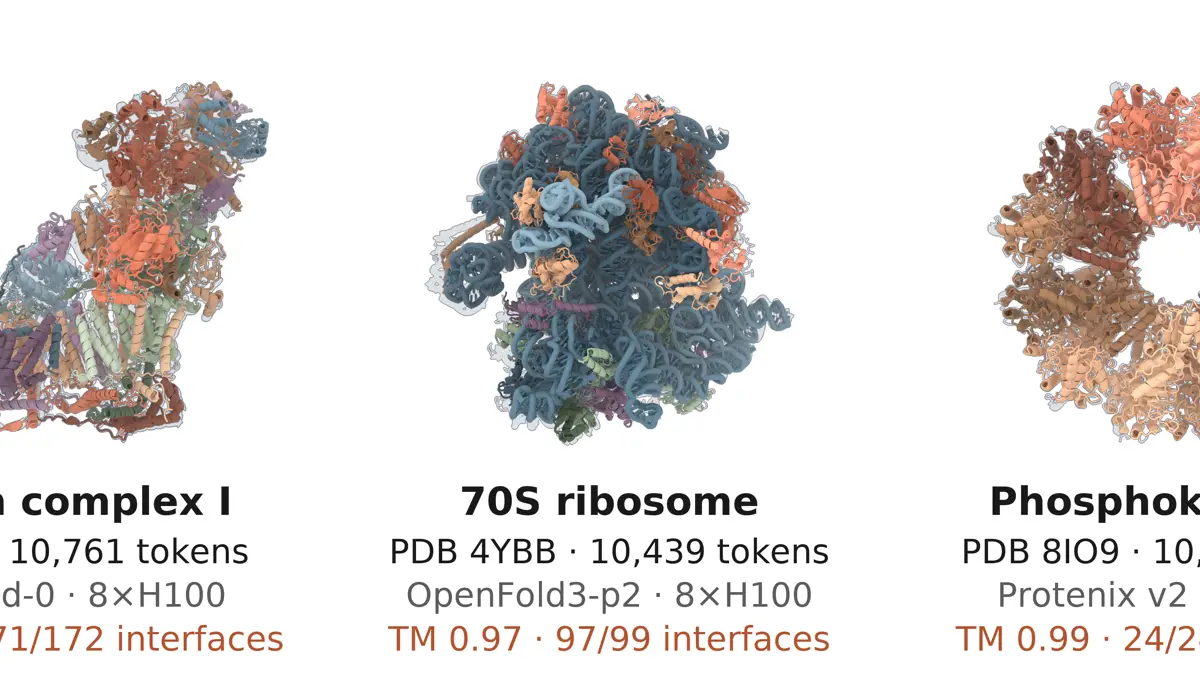
Anthropic、Claudeがオープンソースの生体分子モデル30超を4週間弱で平均約4倍高速化 三角注意のカーネル「FlashPairformer」は既存標準比2.7〜2.9倍、「Big」モードで1万トークン超のリボソーム等を1ノードで予測。結合タンパク質の設計はH200 1枚・約150ドルで前回(GPU時間100分の1)と同等。Adaptyv Bioと設計コンペ、クレジット最大100万ドル
Anthropic、Claudeがオープンソースの生体分子モデル30超を4週間弱で平均約4倍高速化三角注意のカーネル「FlashPairformer」は既存標準比2.7〜2.9倍、「Big」モードで1万トークン超のリボソーム等を1ノードで予測。結合タンパク質の設計はH200 1枚・約150ドルで前回(GPU時間100分の1)と同等。Adaptyv Bioと設計コンペ、クレジット最大100万ドル
検証
Google「Credentio」 C2PAコンテンツ認証情報を検証するC++ライブラリをオープンソース化。約40のGoogle製品で数百億件の生成物を扱ってきたのと同じコードで、仕様2.2と2.4に対応。完全にローカルで検証(送信なし・即時判定)、数GBの動画でもメモリ消費は小さく、公式のC2PA Trust Listを渡せる。生成・埋め込みは今後
Google「Credentio」C2PAコンテンツ認証情報を検証するC++ライブラリをオープンソース化。約40のGoogle製品で数百億件の生成物を扱ってきたのと同じコードで、仕様2.2と2.4に対応。完全にローカルで検証(送信なし・即時判定)、数GBの動画でもメモリ消費は小さく、公式のC2PA Trust Listを渡せる。生成・埋め込みは今後
検証
Raspberry Pi 5でGemma 4 E2Bをオフライン実行 LiteRT-LMでプリフィル99トークン/秒・デコード9トークン/秒・ピークメモリ1,432MB、生成は約300語/分(人の会話の2倍)。GPUにYOLOの物体検出を逃がし、CPUでMoonshineの音声認識・Gemma・TTSを回すReachy Miniロボットの構成。pip install litert-cliで開始
Raspberry Pi 5でGemma 4 E2Bをオフライン実行LiteRT-LMでプリフィル99トークン/秒・デコード9トークン/秒・ピークメモリ1,432MB、生成は約300語/分(人の会話の2倍)。GPUにYOLOの物体検出を逃がし、CPUでMoonshineの音声認識・Gemma・TTSを回すReachy Miniロボットの構成。pip install litert-cliで開始
検証
Google「LiteRT.js」 .tfliteモデルをブラウザで動かすJavaScript版LiteRT。TensorFlow.jsのJSカーネルでなくネイティブのランタイムをWebAssemblyで提供し、CPU(XNNPACK)・GPU(WebGPU)・NPU(WebNN)を使い分け。他のWebランタイム比で最大3倍、CPU比でGPU/NPUは5〜60倍
Google「LiteRT.js」.tfliteモデルをブラウザで動かすJavaScript版LiteRT。TensorFlow.jsのJSカーネルでなくネイティブのランタイムをWebAssemblyで提供し、CPU(XNNPACK)・GPU(WebGPU)・NPU(WebNN)を使い分け。他のWebランタイム比で最大3倍、CPU比でGPU/NPUは5〜60倍
検証
Google DeepMind「クライアントSDKの生成はオープンであるべき」 2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守
Google DeepMind「クライアントSDKの生成はオープンであるべき」2026年5月、使っていたSDK生成ベンダーが買収され突然の終了。Interactions APIのGA直前に乗り換え、Speakeasyと組んでOpenAPI生成スイートをAGPLv3でオープンソース化。7言語のSDK・エージェント向けCLI・ドキュメントMCPサーバーを生成、6ターゲットを約1人で保守
検証
Google「autofinetune」 仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
Google「autofinetune」仕様書1枚を書いて寝ると、エージェントが一晩でLoRAのランク・学習率・バッチを探索し、改善したコミットだけGitに残す。TPU v5eでFunctionGemma 270MのSFTを20回、TPU v6eでGemma 3 1BのGRPOを40回回し報酬約10%改善。Tunix+Antigravity CLI+Gemini 3.7 Flash
検証
Cline、日本からオープンウェイトモデルを配信する「ai&」に新規対応(既定モデルGLM 5.3) DesktopアプリもLinux初対応
Cline、日本からオープンウェイトモデルを配信する「ai&」に新規対応(既定モデルGLM 5.3)DesktopアプリもLinux初対応
検証
Google「ADK for Kotlin 1.0」が正式版 Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
Google「ADK for Kotlin 1.0」が正式版Python版・Java版のADK 1.0と同じ機能に加え、Android向けの端末内エージェント(LiteRT-LM・ML Kitベータ)、Firebase AI Logicのハイブリッド、RoomとAppSearchで状態の保存。@Toolと@Paramでスキーマを自動生成、SKILL.mdで手順を段階的に読む
検証