Alibaba、Qwen-Image-2.1の重みを公開──絵を描く部分は7B、自社ベンチで29モデル中7位(Nano Banana 2.0より上)、透明PNGと参照10枚の編集を1モデルで。ライセンスは研究限定
AlibabaのQwenチームが2026年9月20日、画像生成モデルQwen-Image-2.1の重みをHugging FaceとModelScopeで公開しました。生成と編集を1モデルに統合し、透明画像(RGBA)の生成・編集、最大10枚の参照画像、丸囲みでの局所編集に対応します。絵を描く部分は7B(テキストエンコーダQwen3-VL 8Bを足すと約15B・重み33GB)。公式のQwen-Image-Benchでは29モデル中7位の60.28で、パラメータ数が公開されているモデルの中では最高点です。ライセンスはQwen Research License(非商用)で、過去のQwen-Image 6モデルのApache-2.0から変わりました。
目次
2026年9月20日夜・日本時間時点の情報です。AlibabaのQwenチームが9月20日、画像生成モデルQwen-Image-2.1の重みをHugging FaceとModelScopeで公開しました。文章から画像を作る生成と、画像の編集を1つのモデルで行い、透明画像(RGBA)の生成と編集にも最初から対応します。絵を描く部分(Single-Stream DiT)は7Bで、2月に出たQwen-Image-2.0(Qwen Chat限定・重み非公開)の系統では初めてのオープンウェイトです。ただしライセンスは**Qwen Research License(非商用・研究と評価のみ)**で、これまでのQwen-Image系列のApache-2.0から変わっています。
動画版も公開しています: https://youtu.be/1u8NTSxuIvY
3行まとめ
- 絵を描く部分は7B(32層Single-Stream DiT)。テキストエンコーダはQwen3-VL 8Bで、重みの合計はbf16で33GB。ComfyUI用のint8版は本体7.26GB・エンコーダ6.31GB(w4a8)
- 公式のQwen-Image-Benchでは29モデル中7位(60.28)。Nano Banana 2.0(59.82)・GPT Image 1.5(59.65)・Seedream 5 Pro(59.53)より上、GPT Image 2.5 Sunburst(67.01)など閉じたモデル6つが上位。パラメータ数が図に出ているモデルの中では最高点(FLUX 2 Max 32Bは55.33)
- ライセンスはQwen Research License。使用・配布・改変は「非商用(研究または評価)目的のみ」で、商用は別途申請。過去のQwen-Image・Edit・Edit-2509・Layered・Edit-2511・2512の6モデルはすべてApache-2.0だった(筆者がHugging Faceのタグで確認)
何が出たのか
| 項目 | 内容(出典) |
|---|---|
| 公開日 | 2026年9月20日(公式ブログ・Hugging Faceの最終更新は同日09:41 UTC) |
| モデル | Qwen-Image-2.1。テキスト→画像の生成と画像編集を統合。透明画像(RGBA)の生成・編集にネイティブ対応(公式ブログ) |
| 大きさ | 視覚生成部(Transformer)7B・32層Single-Stream DiT。テキストエンコーダはQwen3-VL 8B。VAEは64チャンネルRGBA・16倍空間圧縮(GitHub README) |
| 重みの実サイズ | text_encoder 17.53GB/transformer 14.23GB/vae 1.35GB=合計33.13GB(bf16・Hugging Faceのファイル一覧) |
| 解像度 | ネイティブ2K。1:1=2048×2048、16:9=2752×1536など7比率。既定40ステップ(GitHub README) |
| 編集 | 参照画像は最大10枚。局所指定は丸囲み・塗り・別マスクの3方式(公式ブログ) |
| 置き場所 | Hugging Face/ModelScope。コードはGitHub。デモはHugging Face Space(gradio・9月20日作成) |
| 初日対応 | Diffusers(QwenImage21Pipeline・PR #14804)/ComfyUI(Comfy-Org配布の重み+ワークフロー雛形)/vLLM-Omni/SGLang(PR #39983)/LightX2V(GitHub README) |
| 付属モデル | プロンプト書き換え用のQwen-Image-2.1-PE-T2I/PE-I2I(Qwen3.5-VL 9Bのファインチューン) |
| ライセンス | Qwen Research License Agreement(非商用のみ。商用は別途申請) |
公式ブログの書き出しはこうです。
We are excited to open-source Qwen-Image-2.1, an image model in the Qwen family that balances generation quality, inference efficiency, and cost. Qwen-Image-2.1 unifies text-to-image generation and image editing in a single model, with just 7B parameters in its visual generation component and native support for generating and editing transparent images. (Qwenファミリーの画像モデルQwen-Image-2.1をオープンソース化する。生成品質・推論効率・コストのバランスを取ったモデルで、テキストからの画像生成と画像編集を1つのモデルに統合し、視覚生成部はわずか7Bパラメータ、透明画像の生成と編集にネイティブ対応する)
「7B」は視覚生成部だけの数字です。テキストの指示と入力画像を読むエンコーダがQwen3-VL 8Bで、これを足すと約15B、重みの合計は33GBになります。
公式ベンチでの位置──29モデル中7位、パラメータ公開組では最高点
公式ブログの比較図は、Qwenが5月に公開した評価Qwen-Image-Benchの総合点で29モデルを並べています。
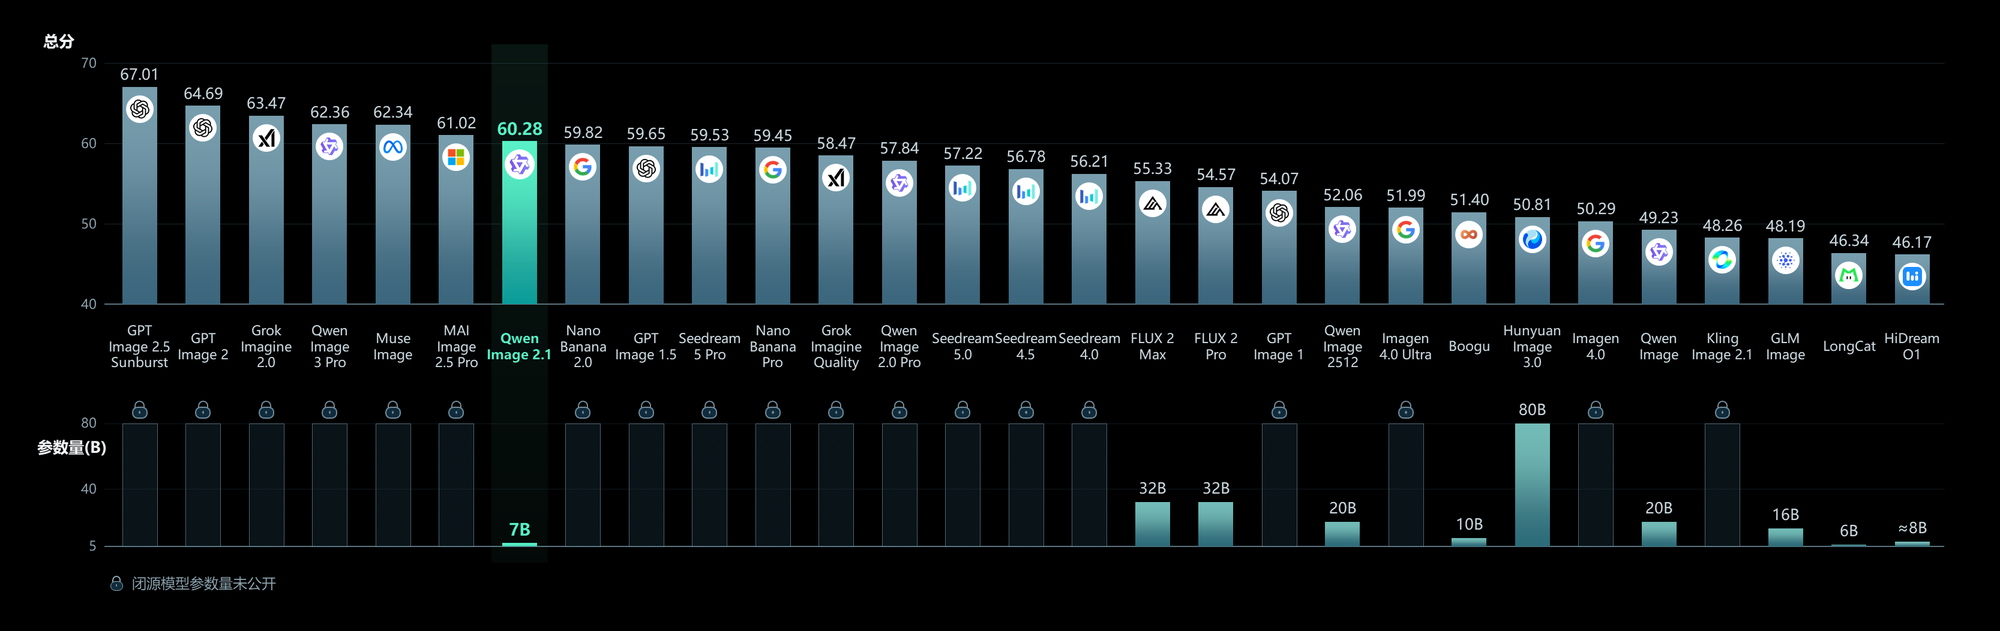
| 順位 | モデル | 総合点 | パラメータ |
|---|---|---|---|
| 1 | GPT Image 2.5 Sunburst | 67.01 | 非公開 |
| 2 | GPT Image 2 | 64.69 | 非公開 |
| 3 | Grok Imagine 2.0 | 63.47 | 非公開 |
| 4 | Qwen Image 3 Pro | 62.36 | 非公開 |
| 5 | Muse Image | 62.34 | 非公開 |
| 6 | MAI Image 2.5 Pro | 61.02 | 非公開 |
| 7 | Qwen Image 2.1 | 60.28 | 7B |
| 8 | Nano Banana 2.0 | 59.82 | 非公開 |
| 9 | GPT Image 1.5 | 59.65 | 非公開 |
| 10 | Seedream 5 Pro | 59.53 | 非公開 |
| 11 | Nano Banana Pro | 59.45 | 非公開 |
(公式図から筆者が転記。以下、Grok Imagine Quality 58.47、Qwen Image 2.0 Pro 57.84、Seedream 5.0 57.22、4.5 56.78、4.0 56.21と続く)
図でパラメータ数が出ているモデルだけを抜くと、Qwen-Image-2.1の60.28が最高点で、FLUX 2 Max(32B)55.33、FLUX 2 Pro(32B)54.57、Qwen Image 2512(20B)52.06、Boogu(10B)51.40、Hunyuan Image 3.0(80B)50.81、初代Qwen Image(20B)49.23、GLM Image(16B)48.19、LongCat(6B)46.34、HiDream O1(約8B)46.17です。初代Qwen-Imageの20Bから、7Bで11.05点上げた形になります。
Qwen-Image-Benchは、Qwen自身が公開した評価です。1,000本の中英プロンプト(5つの大分類・56の評価項目)を、Qwen3.6-27Bをもとに作った判定モデルQ-Judgerが採点します(データセットのREADME)。外部の検証ではありません。また、この図は文章から画像を作る側の点数で、編集性能を数値で比べた表は今回のブログにありません。
7Bで済む仕組み──入力画像と指示は最初の1回だけ計算する
公式ブログとGitHub READMEが説明している仕組みは、注意機構の掛け方を場所で変えるものです。文章(システムの前置き・編集指示)はトークン単位の因果マスク、画像はチャンク単位の双方向マスクで処理します。
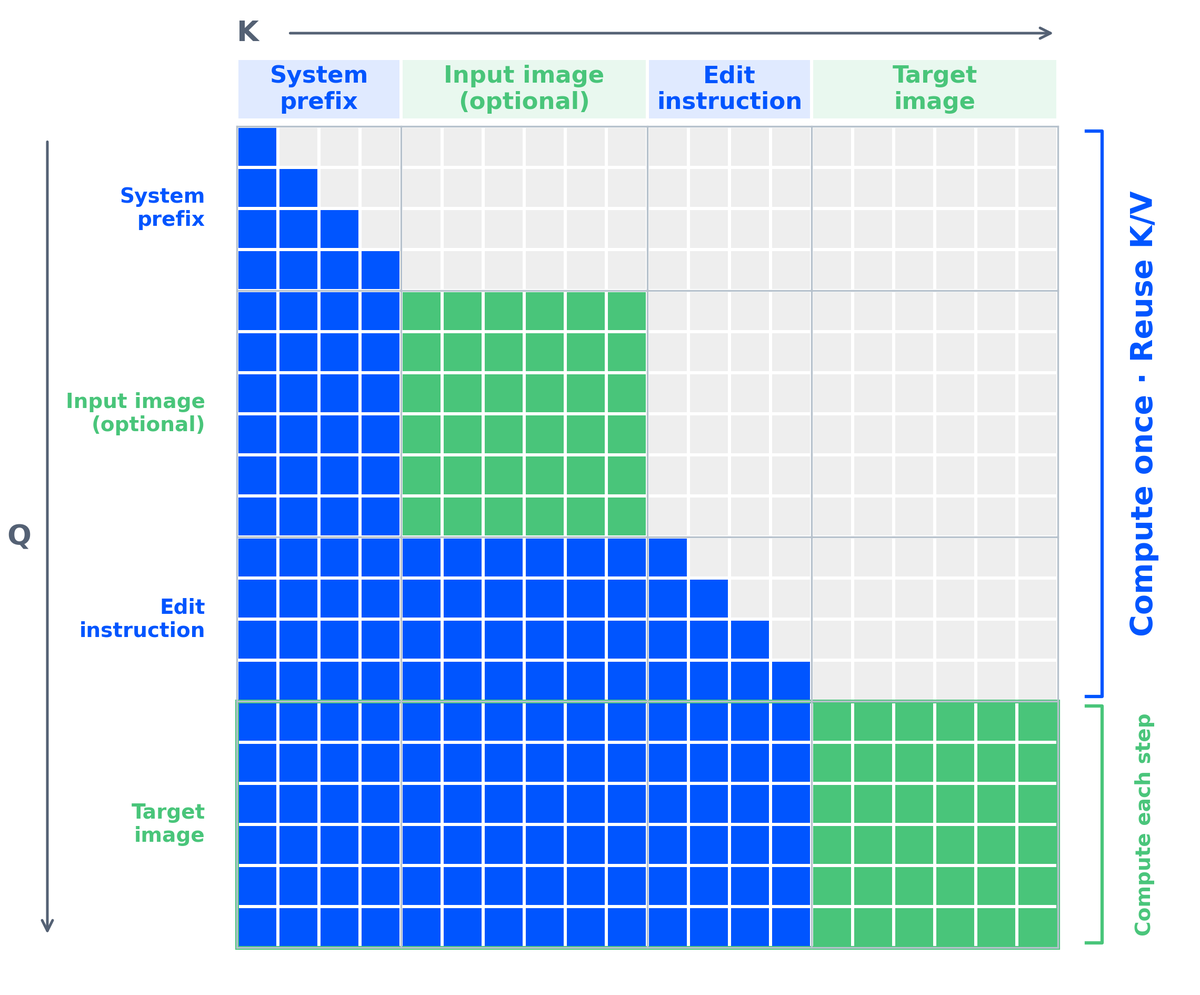
入力画像と編集指示は「静的コンテキスト」として最初のデノイズステップで1回だけ計算し、KVキャッシュに置いて以降の全ステップで再利用します(causal_condition: trueが既定)。既定の40ステップで、参照画像が10枚ある編集でもその10枚を読むのは1回で済み、公式はこれで速度とメモリの両方を改善したと書いています。
透明画像──文章から直接、編集も、写真からの抜き出しも
2025年12月のQwen-Image-Layeredは透明画像専用の別モデルでしたが、2.1はその機能を1つのモデルに統合しました。プロンプトで通常画像かアルファ付きかを決めます。GitHub READMEの推奨書式は次の通りです。
This is an RGBA image with transparency. <your description>. The image has alpha channel and the background is transparent.
公式ブログの作例は、文章だけから作った透明画像(キャラクターのステッカー、複数のオーナメントの束)、透明画像のまま表情を変える編集、透明レイヤー内の文字「BLOOM」を「Qwen-Image」に書き換える編集、そして普通の写真から欲しい被写体だけを透明レイヤーとして抜き出す例です。
参照10枚と丸囲みの局所編集
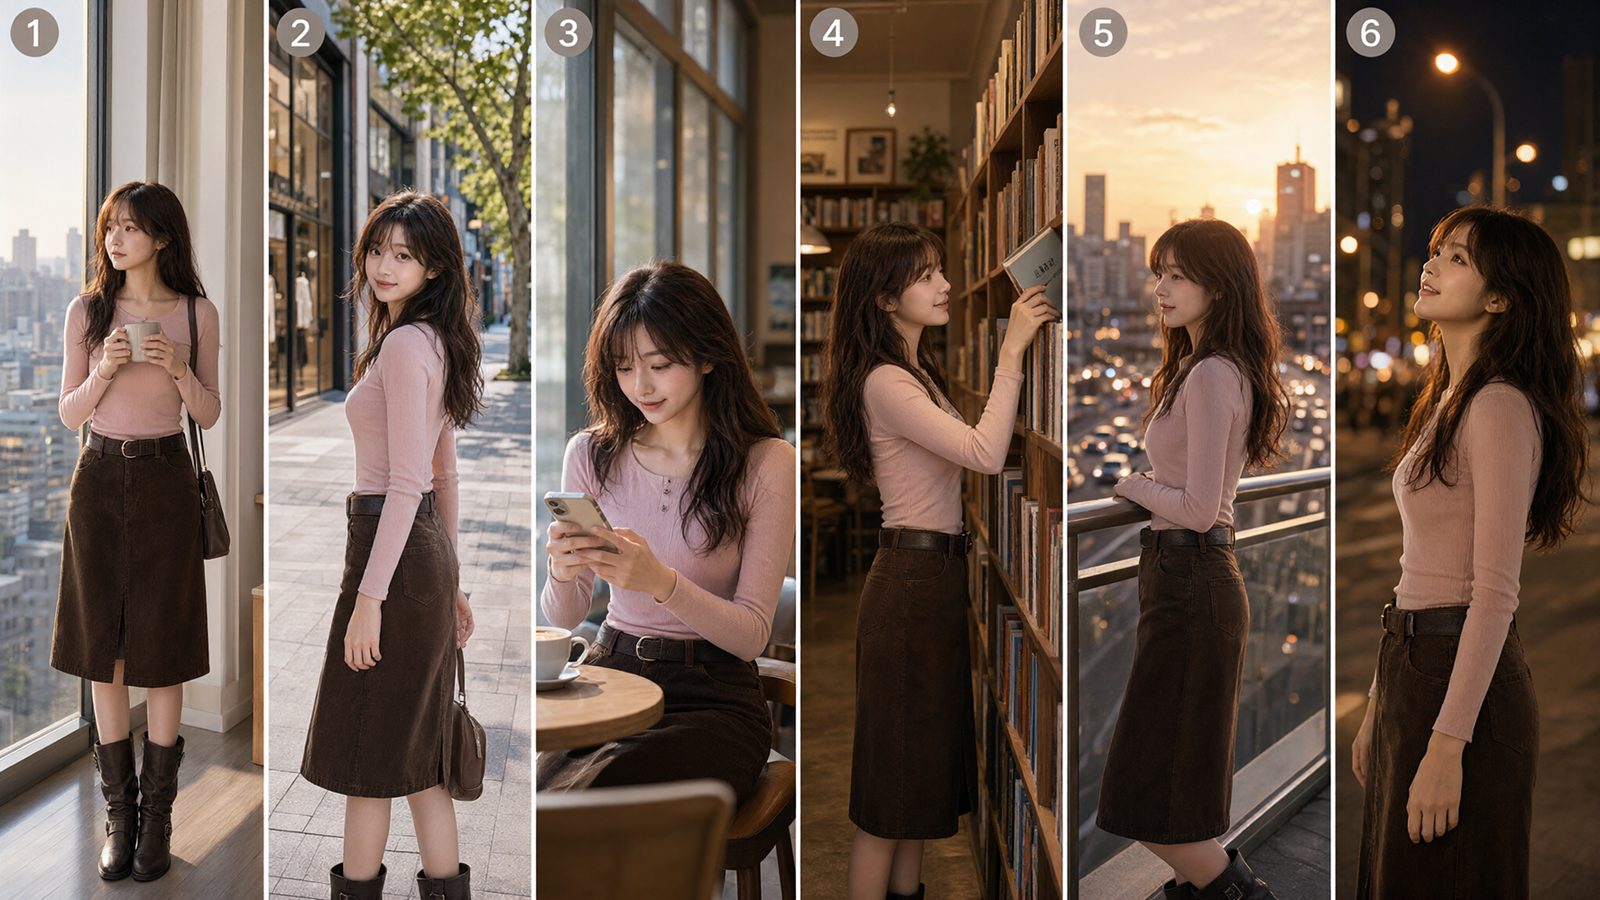
参照画像は最大10枚です。公式の作例は、6人の個別ポートレートから1枚の集合写真、モデル・服・靴・バッグ・帽子の5枚から着せ替えの1枚、家具10枚から部屋の1枚です。
局所編集の指定は3方式で、丸で囲む、塗って示す、元画像と別のマスク画像を2枚渡す、です。丸囲みの作例では、青・赤・緑の3つの丸を描いた1枚に「青丸の金属の時計を消す、赤丸の髪を黒にする、緑丸をグレーのリネンの半袖パジャマにする」と指示し、3か所を一度に編集しています。
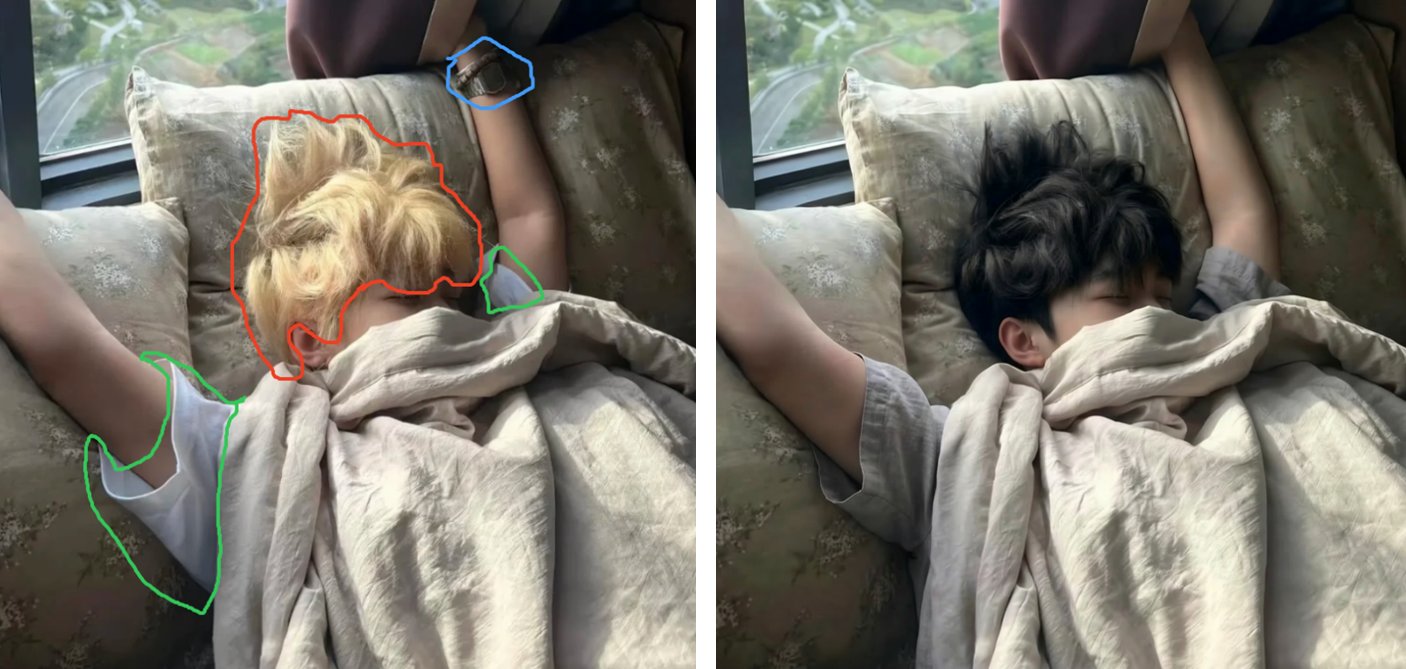
丸や塗りは元の絵を隠すので、隠したくない場合は元画像とマスクを別々に渡す方式が用意されています。人物は顔の特徴を保って同一人物に見えるように、商品は文字・質感・形を保つように改善した、と公式は書いています(作例のみで数値はありません)。
文字・パノラマ・絵コンテ
文字描画は、内容だけでなく書体・配置・構図との関係まで考慮すると公式は書いています。作例には、英語の論文の図版を1枚まるごと描いたものや、中国語の城のインフォグラフィックがあります。タスクの幅としては、自撮り1枚からのパノラマ生成、モデル写真からのインフォグラフィック、キャラクターの三面図からの絵コンテが載っています。
動かし方──ComfyUIの最小構成で約14GB
初日から対応しているのはDiffusers(QwenImage21Pipeline)、ComfyUI、vLLM-Omni、SGLang、LightX2Vです。必要なのはtorch 2.4以上、transformers 5.17以上、diffusersはgit版です。
ComfyUI用にComfy-Orgが配布している重みは次の通りです。
| ファイル | 精度 | サイズ |
|---|---|---|
| 本体(diffusion_models) | bf16 | 14.23GB |
| 本体(diffusion_models) | int8 | 7.26GB |
| テキストエンコーダ(qwen3vl_8b) | bf16 | 17.53GB |
| テキストエンコーダ(qwen3vl_8b) | int8 | 9.35GB |
| テキストエンコーダ(qwen3vl_8b) | w4a8 | 6.31GB |
| VAE | bf16 | 0.68GB |
一番小さい組み合わせで本体7.26GB+エンコーダ6.31GB+VAE 0.68GB=約14GBです。必要なVRAMの数字は、GitHub READMEにもHugging Faceのモデルカードにも書かれていません(本記事が確認した範囲)。READMEにはenable_model_cpu_offload()によるメモリ節約と、AMD Radeon(ROCm)対応、FlagOS経由の8チップ向けビルドの記述があります。
手元に置かない選択肢としては、Hugging Face Spaceのデモ(9月20日作成・確認時点で稼働中)と、中国本土向けのwuli.artでの無料提供がREADMEに書かれています。サーバー用途ではvllm serve Qwen/Qwen-Image-2.1 --omniで立ち上げ、OpenAI互換の/v1/images/generationsで叩けます。ModelScopeのDiffSynth-StudioではLoRA学習ができるとも書いています。
プロンプトは、公式が同日公開した書き換えモデル(Qwen-Image-2.1-PE-T2I/PE-I2I・Qwen3.5-VL 9Bのファインチューン)で短い指示を詳細な英語に広げ、縦横比まで決める運用が推奨されています。
ライセンス──Qwen-Image系列で初の「非商用」
Hugging Faceに置かれたLICENSEはQwen RESEARCH LICENSE AGREEMENT(発効日2026年9月20日・権利者はHangzhou Tongyi Laboratory Technology Co., Ltd.)です。
"Non-Commercial" shall mean for research or evaluation purposes only. (「非商用」とは、研究または評価の目的のみを意味する)
You are granted a non-exclusive, worldwide, non-transferable and royalty-free limited license under our intellectual property or other rights owned by us embodied in the Materials to use, reproduce, distribute, copy, create derivative works of, and make modifications to the Materials FOR NON-COMMERCIAL PURPOSES ONLY. (あなたには、マテリアルの使用・複製・配布・コピー・派生物の作成・改変について、非商用目的に限り、非独占的・全世界・譲渡不可・無償の限定的ライセンスが付与される)
商用利用は別途ライセンスが必要で、条文には申請先のメールアドレス(model-business@notice.qwencloud.com)が書かれています。出力を使って他のモデルを学習・改良して配布する場合は「Built with Qwen」または「Improved using Qwen」の表示が必要、「Qwen」を製品の主名称にしない、準拠法は中国法で杭州の人民法院が専属管轄、権利者に対して訴訟を起こすとライセンスが終了する、といった条項もあります。
この記事を書いている筆者は、9月20日夜にHugging FaceのAPIで過去のQwen-Image系列6モデルのライセンスタグを1つずつ確認しました。
| モデル | Hugging Faceリポジトリ作成 | ライセンス |
|---|---|---|
| Qwen-Image | 2025-08-02 | Apache-2.0 |
| Qwen-Image-Edit | 2025-08-17 | Apache-2.0 |
| Qwen-Image-Edit-2509 | 2025-09-22 | Apache-2.0 |
| Qwen-Image-Layered | 2025-12-17 | Apache-2.0 |
| Qwen-Image-Edit-2511 | 2025-12-17 | Apache-2.0 |
| Qwen-Image-2512 | 2025-12-30 | Apache-2.0 |
| Qwen-Image-2.1 | 2026-09-14 | Qwen Research(非商用) |
6モデルはすべてApache-2.0で、Qwen-Image系列で非商用ライセンスは今回が初めてです。個人が試す分には研究・評価の範囲ですが、仕事の納品物に使う場合は条文を読んだうえで判断が要ります。
公式資料の中で筆者が見つけた点と、まだ無いもの
- 比較図に「Qwen Image 3 Pro」が載っている。62.36点で4位、鍵印(閉じたモデル)です。本文にもREADMEにもこの名前の説明はありません。同じ図には「Qwen Image 2.0 Pro」(57.84・閉じたモデル)もあり、2.1のオープンウェイト版がこれを上回る位置にあります。
- APIやQwen Chatでの提供は今回のブログに記述がありません。前のQwen-Image-2.0(2026年2月10日)は公式ブログのリンクがQwen ChatとDiscordだけで、GitHubにもHugging Faceにも置かれませんでした。
- 編集性能の数値表と、VRAM・生成速度の実測値は公式資料にありません。「faster inference」は定性的な記述のみです。
- Hugging Faceのリポジトリは9月14日に作成され、公開は9月20日。筆者が取得した22:52(日本時間)の時点でダウンロード数は183、likesは155でした。動かした報告はこれからです。
- 当サイトはまだ手元で動かしていません。ComfyUIでの透明画像と参照10枚の編集は検証してから続報で出します。
本記事は続報があり次第更新します。
関連記事
出典・参照資料
- 一次資料Qwen公式ブログ「Qwen-Image-2.1: Compact, Efficient, and Unified Image Creation」(2026-09-20) ↗
- 一次資料Hugging Face Qwen/Qwen-Image-2.1(LICENSE・README・ファイル一覧) ↗
- 一次資料GitHub QwenLM/Qwen-Image-2.1(README) ↗
- 一次資料Hugging Face Comfy-Org/Qwen-Image-2.1(ComfyUI用の重み) ↗
- 一次資料Hugging Face datasets Qwen/Qwen-Image-Bench ↗
- 一次資料Qwen公式ブログ「Qwen-Image-2.0」(2026-02-10) ↗
この記事の解説動画
YouTubeで見る ↗AIニュースの解説を動画でも
YouTubeでは注目ニュースの背景を解説し、Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →新しい記事をメールで受け取る
AIの新しい発表を、出典付きで整理して届けます。
関連記事
Alibaba、Qwen3.8-Omni-Flashを発表──音声1時間の入力が1セント未満、会議の文字起こしはDER 88.1→3.4、Gemini 3.8 Flashに音声で上・動画推論で下、重みは非公開
ChatGPT Images 2.5登場──無料含む全プランに今日から、改善4つと新機能4つ、APIはFlare/Sunburstの2モデルでGPT-Image-2と同額
ローカルAIの画像生成は単体グラボなしでも動くのか──条件で見る判定

Qwen3.8-27Bが公開──1枚のGPUに収まる密モデルで動画も読める、ダウンロード330万回・likes 1.3万で中国勢8月最多
diffusersの「Modular Diffusers」が実験段階を卒業──新モデルは既に旧来パイプラインを持たずModular専用で配布される
車をチャットルームの一員にする──Raspberry Pi 5に35BのQwenを載せて完全オフラインで動かすCarWatch
ComfyUIで生成が止まる・エラーが出る時の切り分け手順──公式トラブルシューティングを読む