ChatGPTの文章にも透かし、ただし入るのはEUだけ日本は今のところ対象外。Claudeは全世界で、Opus 5.5やSonnet 5.5にはもう入っている
OpenAIは2026年10月5日、EUのAI法への対応として、ChatGPTとCodexの文章に見えない透かし「textGrain」を数週間かけて入れると発表した。対象はEUの利用者だけで、APIは全世界で任意・初期設定はオフ。一方のClaudeは「地域で分ける確かな方法がまだ無い」として全世界に適用しており、Opus 5.5やSonnet 5.5の文章にはすでに入っている。
目次
2026年10月6日朝(日本時間)時点の情報です。OpenAIは10月5日、EUのAI法(AI Act)への対応として、ChatGPTとCodexが書く文章に目に見えない透かし(ウォーターマーク)を入れると発表した。ただし入るのはEUの利用者だけで、日本を含むほかの地域のChatGPTには、発表の時点では入らない。8月に全世界で透かしを入れ始めたAnthropicのClaudeとは、同じ法律への対応でも範囲がまるで違う。両社の発表とヘルプページを読み比べた内容を、解説動画「【悲報】ChatGPTの文章にも「透かし」導入へ…日本はセーフ?Claudeとの違いを解説」にまとめた。この記事は、その原文と数字を並べたものだ。
3行まとめ
- OpenAIの文章の透かし「textGrain(テキストグレイン)」は、ChatGPTとCodexではEUの利用者だけに数週間かけて入る。APIは全世界で入れるかどうかを選べ、初期設定はオフ。透かしを見分ける検出器は、審査を通った研究者・専門機関だけに渡す。
- OpenAI自身の評価では、誤検出を1%に抑える設定で、400トークンの文章の約95%から透かしを見つけた。ただし400トークンの文章で単語の25%を言い換えると、見つかる割合は17%まで落ちる。
- Claudeは「地域で分ける確かな方法がまだ無い」として全世界に適用している。Claudeのヘルプページの表では、Fable 5.1・Opus 5.5・Sonnet 5.5を含む8モデルの文章にすでに入っている。
| 文章の透かし | Claude(Anthropic) | ChatGPT・Codex(OpenAI) |
|---|---|---|
| 地域 | 全世界 | EUだけ |
| アプリ | 入る | EUでは入る |
| API | 入る | 全世界で選べる(初期設定はオフ) |
| 検出器 | 規制当局・報道機関などに限った非公開の試験提供 | 審査を通った研究者・専門機関だけ |
| 方式 | Google DeepMindのSynthID-Textの一種 | 自社のtextGrain |
| 始まり | 2026年8月2日以降のモデルから | 10月5日の発表から数週間かけて |
ChatGPTとCodexはEUだけ、最初から全世界の標準にはしない
EUのAI法は、生成AIの会社に、AIが作った文章を機械で見分けられるようにすることを求めている。OpenAIの発表は、この要求への対応を3つに分けて説明している。1つ目がChatGPTとCodexへの透かしだ。
Over the coming weeks, we will introduce text watermarking to eligible ChatGPT and Codex users across all plans in the EU only. We are not making text watermarking a global default at launch.
(今後数週間で、EUの全プランの対象となるChatGPTとCodexの利用者に、文章の透かしを導入する。最初から全世界の標準にはしない)
OpenAIは、地域を絞る理由を「実際の使われ方と反応から学ぶ余地ができる」と書いている。2つ目はAPIで、全世界の開発者が、一部のモデルについて透かしを入れるかどうかを選べるようになった。初期設定はオフのままだ。
Starting today, API customers globally will be able to opt in to text watermarking for select models. Text watermarking will remain off by default in the API.
(本日から、全世界のAPIの顧客が、一部のモデルで文章の透かしを選んで有効にできる。APIでは、透かしは初期設定でオフのままとする)
3つ目が検出器だ。最初は審査を通った研究者と専門機関にだけ使わせ、一般には公開しない。理由は、見落としと誤検出のおそれがあるからだという。OpenAIは、検出器は透かしの有無を答えるだけで、利用者や会話の中身は明かさないとも書いている。
textGrainは短い文と言い換えに弱いと、OpenAI自身が数字で示した
textGrainは、AIが次の言葉を選ぶときの選び方に、目に見えない統計の信号を混ぜる仕組みだ。検出器は、その信号が文章に残っているかを調べる。OpenAIは、Googleの文章用SynthIDを含めて試した方式と比べて「同等以上」だったとしたうえで、理想的な条件での成績が日常での確実な検出を約束するものではないと書き、弱点の数字を出している。
| 条件(誤検出1%の設定) | 透かしが見つかった割合 |
|---|---|
| 200トークンの文章(心理学の質問への回答) | 約80% |
| 400トークンの文章(同上) | 約95% |
| 400トークン・単語の10%を同じ意味の語に置き換え | 約92%→66% |
| 400トークン・単語の25%を置き換え | 17% |
数学のように言葉の選び方の自由が少ない文章では、見つかる割合が「大幅に低い」とも書いている。短い文章、答えが1つに決まる文章、手直しした文章ほど、透かしは残りにくい。
文章の質については、OpenAIが自社の最新のフロンティアモデルと説明するAstra(max)で、8つのテストを透かしありとなしで比べ、「意味のある差は見られない」としている。
| テスト | 透かしなし | 透かしあり |
|---|---|---|
| Artificial Analysis Intelligence Index | 49.57点 | 49.76点 |
| AutomationBench | 34.09% | 34.86% |
| DeepSWE v1.1 | 72.80% | 71.68% |
| Terminal-Bench 4.0 | 53.90% | 56.06% |
| Terminal-Bench Science 0.1 | 56.90% | 60.00% |
| BrowseComp | 87.92% | 87.35% |
| HealthBench Professional | 64.27% | 64.60% |
| GPQA Diamond | 94.44% | 93.94% |
Claudeは「地域で分ける確かな方法がまだ無い」として全世界に
Anthropicは8月14日の解説で、全世界に入れた理由をこう書いている。
We’re applying watermarking globally at launch because we don't yet have a durable way to scope it by region.
(地域ごとに範囲を絞る確かな方法がまだ無いため、最初から全世界に透かしを適用している)
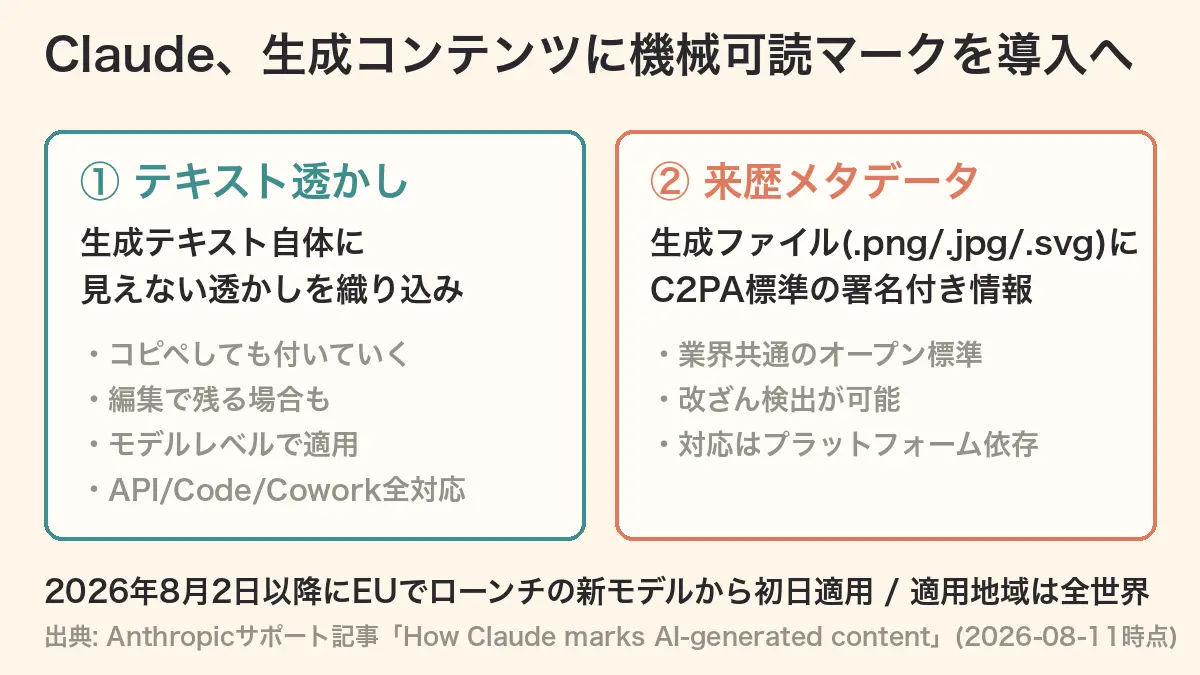
Claudeのヘルプページによると、透かしはモデルそのものに入れる方式で、Claudeのアプリ、Claude Code、API、AWSやGoogle Cloud、Microsoft Foundry経由のどこから使っても入る。2026年8月2日以降に出たモデルは最初から対応していて、ヘルプページの表で文章の透かしに印が付いているのは、Fable 5.1・Fable 5・Mythos 5.1・Opus 5.5・Opus 5・Opus 4.8・Sonnet 5.5・Sonnet 5の8つだ。Mythos 5・Opus 4.7・Opus 4.6・Opus 4.5・Sonnet 4.6・Sonnet 4.5・Haiku 4.5の7つはまだ空欄で、Anthropicは前の世代にも追加を進めているとしている。透かしを調べる検出APIは、規制当局・報道機関・研究者など、EUの法律が求める組織に限った非公開の試験提供だ。
OpenAIは製品ごと(ChatGPTとCodex)に地域を絞り、APIは開発者に選ばせた。Anthropicはモデルに入れたので、どの製品から使っても同じになる。範囲の違いは、この入れ方の違いとも重なっている。
日本でChatGPTを使う人にとって、どこまでがセーフか
発表どおりなら、日本でChatGPTやCodexが書く文章には透かしは入らない。ただ、線はいくつかある。
- セーフなのは文章だけ。 OpenAIのヘルプによると、ChatGPT・Codex・APIで作った対応画像には、来歴の情報(C2PA)と見えない透かし(SynthID)の両方が入り、生成した対応音声にもSynthIDが入る。発表は、EUだけの話が文章に限ったものだと明記している("The above only applies to text provenance")。
- APIでオンにしたサービスは別。 開発者が透かしを有効にしたサービスを日本で使えば、その文章には入る。
- 見直しが前提。 OpenAIは "We expect to revisit each part of this approach as the technology, standards, and evidence evolve."(技術や基準、根拠の変化に合わせて、この方針のそれぞれを見直すつもりだ)と書いている。
OpenAIがEUの利用者をどう見分けるのか(住んでいる場所か、アカウントの国か、接続元か)は、本記事が確認した範囲(発表本文、ヘルプの英語版・日本語版、開発者向けの来歴ガイド)では書かれていなかった。10月6日朝に日本語版のヘルプを開くと、ページには「更新日: 10 時間前」と出ていたが、文章については「テキストを含むすべてのモダリティに来歴シグナルを拡大することを目指しています」という、これからの予定の書き方のままだった。Claude側についても、利用者が透かしを切れるかどうかは、確認したヘルプと解説には書かれていない。
8月に書いた「EUだけでやってほしい」を、OpenAIが形にした
当チャンネルは8月11日、Claudeの透かしを動画「【悲報】Claude 生成文に透かし文字導入 正直者・消費者だけが損する仕組みへ」で取り上げ、その週の週刊ニュースでは、透かしは単語の選ばれ方に仕掛ける仕組みなので提供地域で切り替える設計もあり得たはずで、本当にEUだけでやってほしい、と話した。2か月後、OpenAIは同じEUの法律への対応として、ChatGPTとCodexについてはまさにその形で出してきた。Anthropicが「まだ無い」と書いた地域の絞り方を、OpenAIはどう実装したのか。その中身は、今回の発表からは分からない。
ここからは推測だ。透かしをモデルそのものに入れたAnthropicと、製品ごとに入れたOpenAIの違いが、地域で分けられたかどうかの差になっているのかもしれない。
EUの規制が、EUの外とEUの人の両方に及んでいる(筆者の意見)
ここからは当サイトの意見だ。正直、EUの法律は迷惑が大きい。EUの法律に合わせた結果、日本でClaudeを使う人の文章にまで透かしが入った。OpenAIは、同じ法律への対応で地域を分けてみせた。少なくとも、EUの外の利用者まで巻き込む形が唯一の答えではなかったことになる。
EUの利用者自身も、新しい機能から遠ざけられている。Appleは6月8日、EUのデジタル市場法(DMA)を理由に、新しいSiri AIをiOS 27とiPadOS 27ではEUで出せないと発表し、提供の時期も決まっていないと書いた("we do not currently have a timeline")。今回の透かしも、入るのはEUのChatGPTとCodexだけだ。欧州委員会は、AI法の狙いを "The AI Act ensures that Europeans can trust what AI has to offer."(AI法は、欧州の人がAIの提供するものを信頼できるようにする)と説明している。信頼できるAIを広めるための法律が、使う人の足を引っ張っているように見える。規制の影響は、EUの中だけで完結してほしいと考えている。
今回の発表で分からないこと
- OpenAIがEUの利用者を判定する方法
- 「数週間かけて」の具体的な日程と、対象となる「eligible(対象となる)」利用者の条件
- APIで透かしを選べる「一部のモデル」がどれか。技術報告は「今後数週間で詳細を追加する」とされ、オープンソースで公開する予定だという
- 検出器の公開範囲がいつ広がるか(両社とも、現時点では審査制)
この記事で参照した一次資料
- OpenAI「Our approach to EU text provenance rules」(2026年10月5日)
- OpenAI ヘルプセンター「OpenAI 生成コンテンツの来歴シグナル」
- OpenAI 開発者向けガイド「Content provenance」
- Anthropic「How Claude’s text watermark works」(2026年8月14日・9月1日更新)
- Claude ヘルプセンター「How Claude marks AI-generated content」
- Apple Newsroom「Due to DMA, Siri AI delayed in EU for iOS 27 and iPadOS 27」(2026年6月8日)
- 欧州委員会「AI Act」
検出率と品質の数字は、すべてOpenAIが自社で行った評価の値で、第三者の検証ではない。Claudeの対応モデルは、2026年10月6日時点のヘルプページの表にもとづく。検出器の公開や方針の見直しなど続報が出たら、この記事に追記する。動画では、両社の違いを図で並べている。疑問や気づいた点はコメントで教えてほしい。
出典・参照資料
- 一次資料OpenAI「Our approach to EU text provenance rules」(2026-10-05) ↗
- 一次資料OpenAI ヘルプセンター「OpenAI 生成コンテンツの来歴シグナル(Content Credentials、SynthID)」 ↗
- 一次資料OpenAI 開発者向けガイド「Content provenance」 ↗
- 一次資料OpenAI「Supporting Europe’s work in ensuring a trustworthy AI ecosystem」 ↗
- 一次資料Anthropic「How Claude’s text watermark works」(2026-08-14・9月1日更新) ↗
- 一次資料Claude ヘルプセンター「How Claude marks AI-generated content」 ↗
- 一次資料Apple Newsroom「Due to DMA, Siri AI delayed in EU for iOS 27 and iPadOS 27」(2026-06-08) ↗
- 一次資料欧州委員会「AI Act」 ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
Claudeが全世界で"見えない透かし"導入へ ただし作った側が「消える」と全部認めている、正直者だけが損する仕組み
Claudeが全世界で"見えない透かし"導入へただし作った側が「消える」と全部認めている、正直者だけが損する仕組み
EU AI法、8月2日から「AIと対話中です」表示が義務化 ― 違反は売上3%の罰金
EU AI法、8月2日から「AIと対話中です」表示が義務化 ― 違反は売上3%の罰金
AI動画に見えない透かしは入っているのか SynthIDとC2PAを公式資料で確認した
AI動画に見えない透かしは入っているのかSynthIDとC2PAを公式資料で確認した
 動画
AI検出ツールは「両方向に壊れている」— 見逃し94%、冤罪61%の現実
AI検出ツールは「両方向に壊れている」— 見逃し94%、冤罪61%の現実
 動画
日本政府、生成AI事業者向けの知財原則「プリンシプル・コード」を決定 法的拘束力なし、今秋にも届出開始
日本政府、生成AI事業者向けの知財原則「プリンシプル・コード」を決定法的拘束力なし、今秋にも届出開始
ディープフェイクとは EU AI法の定義(第3条60号)「実在の人・物・場所・出来事に似せ、本物だと誤認させるAI生成・加工の画像・音声・動画」。Arupから2,560万ドルを取った偽ビデオ会議、Article 50の表示義務(2026年8月2日施行)、SynthID・C2PAの透かしと来歴、YouTubeの開示ルール、日本の景表法の位置を1ページに
ディープフェイクとはEU AI法の定義(第3条60号)「実在の人・物・場所・出来事に似せ、本物だと誤認させるAI生成・加工の画像・音声・動画」。Arupから2,560万ドルを取った偽ビデオ会議、Article 50の表示義務(2026年8月2日施行)、SynthID・C2PAの透かしと来歴、YouTubeの開示ルール、日本の景表法の位置を1ページに
 動画
米控訴裁、国防総省によるClaudeの締め出しを2対1で容認 判決文で読む「問われるのは何をするかで、なぜではない」
米控訴裁、国防総省によるClaudeの締め出しを2対1で容認判決文で読む「問われるのは何をするかで、なぜではない」
 動画