GPT-6 Astraが未発表の理論物理の研究問題を50問中49問正解採点に使った専門家の模範解答の誤りまで見つかった論文「TheoPhysEval」
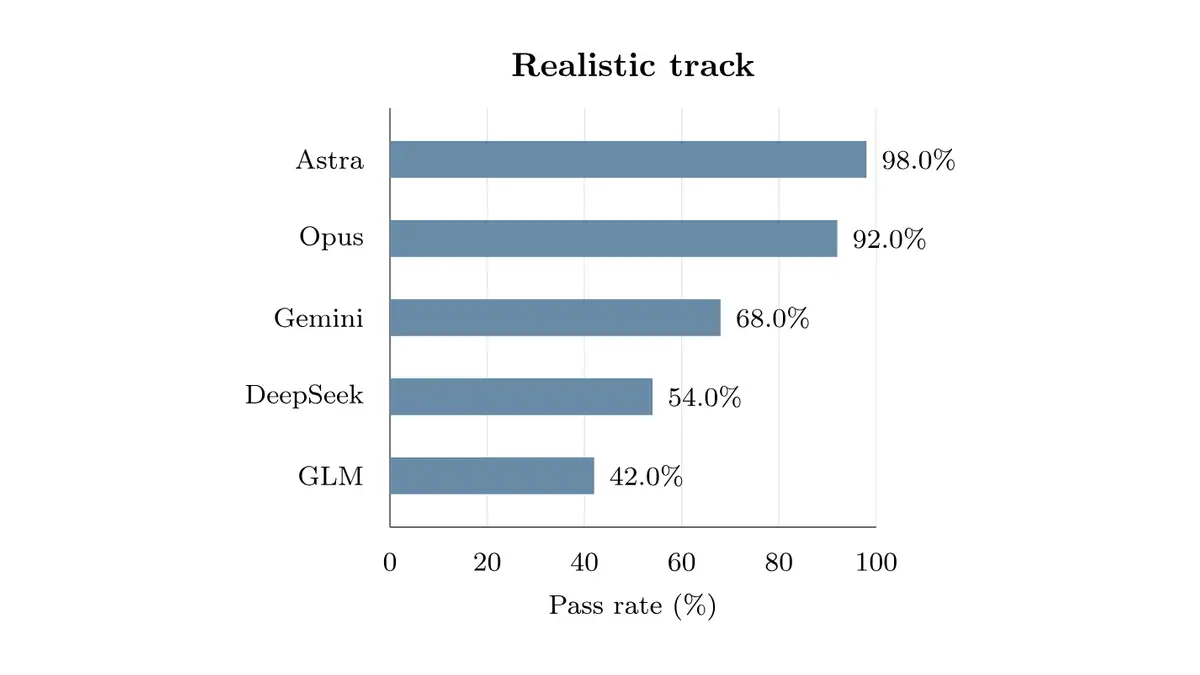
研究者35人の論文「TheoPhysEval」(arXiv 2610.16733・2026年10月9日)は、答えが公開されていなかった理論物理の研究問題50問をAIにヒントなしで解かせ、OpenAIのGPT-6 Astra(Codex)が49問に正解したと報告した。最初にAstraの誤りと判定した複数の問題は、調べ直すと出題した専門家の模範解答の方に誤りがあった。2位はClaude Opus 5.5の46問。
目次
2026年10月15日・日本時間時点の情報です。研究者35人が2026年10月9日にarXivへ投稿した論文「TheoPhysEval」(arXiv 2610.16733)は、答えがまだ公開されていなかった理論物理の研究問題50問を、AIエージェントに人間のヒントなしで解かせた結果を報告している。論文によると、OpenAIのGPT-6 Astra(アストラ)をCodexで動かした組み合わせが50問中49問に正解した。さらに、最初に「Astraの誤り」と判定した複数の問題を調べ直すと、間違っていたのは出題した専門家の模範解答の方だった。
動画版(約12分・採点の机で論文の中身を順番に見せる構成): https://youtu.be/OyM2-Y_94lc
3行まとめ
- 論文によると、問題は世界の第一人者でだいたい1日かそれ以下、隣の分野の専門家ならずっと長くかかる未発表の研究問題50問(11分野)。論文の検索とプログラムの実行ができる条件で、GPT-6 Astra(Codex)は49問、Claude Opus 5.5(Claude Code)は46問に正解した。
- 著者たちは当初、Astraが他にも複数の問題で誤ったと判定したが、専門家と調べ直すと模範解答の側に細かい誤りがあり、直した後はその全部でAstraが正解だったと書いている。
- 著者たちは「一部の最先端モデルは、具体的な計算の力で最高の人間の研究者をすでに超えたかもしれない」と書き、論文の冒頭では、AIの影響がいちばんはっきり出ている分野として数学を挙げている。
5つのAIの成績(論文の表2〜4)
論文は、論文の検索とプログラムの実行ができる条件(realistic track)と、インターネットを切った条件(isolated track)の2つで、5つのAIエージェントを1回ずつ走らせている。
| AI(動かした道具) | 正解(ネットあり) | 正解(ネットなし) | トークン(ネットあり・合計) | API料金に換算(ネットあり) |
|---|---|---|---|---|
| GPT-6 Astra(Codex) | 49/50 | 46/50 | 約3741万 | 116.28ドル |
| Claude Opus 5.5(Claude Code) | 46/50 | 46/50 | 約2億1118万 | 240.43ドル |
| Gemini 3.8 Flash(Antigravity) | 34/50 | 31/50 | 約6億671万 | 95.01ドル |
| DeepSeek-V4.1-Flash(Codex) | 27/50 | 25/50 | 約10億2560万 | 37.42ドル |
| GLM 5.3(Claude Code) | 21/50 | 26/50 | 約9億7196万 | 定額プラン(両条件で180ドル) |
Astraの料金は、合計116.28ドルを50問で割ると1問あたり約2.3ドルになる(論文の要旨は「1問あたり平均3ドル未満」と書く)。考える強さは、論文によるとGemini 3.8 Flashだけが選べる上限の「high」で、ほかは「max」。1問8時間で打ち切り(付録A.6の連続問題だけは合計20時間)。
出題されたのは、答えがどこにも出ていない研究の問題
論文によると、問題は世界の専門家から集め、条件を3つ付けた。現在の研究に関わること、検証は簡単だが当てずっぽうでは当たらない答えがあること、答えが論文などで調べられないこと。出題者には、しばらく答えを発表しないよう依頼している。分野は古典物理から場の量子論、ホログラフィー、重力と宇宙論まで11に分かれ、著者たちは「この中の一部より多くに手を出せる物理学者はいないだろう」と書いている。
例として本文に載っているのが、ブラックストリング(ブラックホールが筒状にのびた時空)に2枚の膜を置いた時の「ページ時間(Page time)」を求める問題だ。問題文は2文しかない。解くには、似た問題を5次元で扱った過去の論文(arXiv:2012.04671)を見つけ、式を4次元に作り直し、そのままでは解けない方程式をプログラムで数値計算する必要がある。論文によると、元の論文の著者の一人(SR)が自分で解いても約1日かかり、AIが出てくる前なら解ける専門家はごく少数で、それでも数日かかっただろうという。
答えは式の形ではなく数値で出させ、自動で採点している。式で答える問題も、論文の Box 2 のように物理量に値を入れて数値にさせた。
「Astraの誤り」は、模範解答の誤りだった
この論文で最も目を引くのは、本文IV.2の次の段落だ。
It is noteworthy that we initially assessed that Astra had made errors in several additional problems. However, upon closer examination and consultation with the experts, we found that there were subtle errors in the original solutions. In all these cases, after the experts corrected their solutions, Astra’s solution was found to be correct.
(特筆すべきことに、私たちは当初、Astraがほかにも複数の問題で誤りを犯したと判定した。しかし、専門家に相談しながら詳しく調べたところ、元の解答の方に細かい誤りがあった。そのすべてのケースで、専門家が解答を直すと、Astraの答えが正しいと分かった。)
つまり49問という数字は、Astraの答えとの食い違いをきっかけに見つかった模範解答の誤りを直してから採点した結果だ。何問だったかの数は本文に書かれていない。
著者たちは序論で、この結果を次のようにまとめている。
Our results indicate that some frontier models may have already surpassed the best human researchers in their ability to perform concrete calculations, even in specialized topics. This is a significant milestone, with implications for education and research in theoretical physics.
(私たちの結果は、一部の最先端モデルが、専門的な分野でも、具体的な計算を行う力で最高の人間の研究者をすでに超えた可能性を示している。これは大きな節目で、理論物理の教育と研究に影響がある。)
考察では「計算の力は、専門分野でも世界の専門家に並んだ。幅はどの個人も超える」と書き、これまで若手の研究者に最初の研究テーマとして渡してきた種類の問題は、答えを出すことが目的なら、もう渡すのはふさわしくないとまで述べている。
Astraの正解の中に、ほかのAIの正解が全部入っていた
論文によると、ネットありのAstraが落とした1問は、5つのAIがどちらの条件でも解けなかった問題だけだった。そのため、ほかのAIが正解した問題(両条件とも)と、ネットなしのAstraの正解は、すべてネットありのAstraの正解の内側に収まる。
5つのAIが全員落としたのは付録Aの問題A.1.2で、グラフ(論文の図1)だけを見せて、微分は1階まで・項は5つ以内・係数はきりのいい数という条件で元の方程式を当てさせる。付録Bによると出題者の答えは、5分の1回と3分の1回の分数回の微分と、時刻を1さかのぼった値を使う遅れの項を含む方程式だった。著者たちは「厳密に見れば不公平に見えるかもしれない」と認めたうえで、ノイズのあるデータから元の仕組みを読み解く実際の研究を表す問題だと書いている。本番とは別の会話では、Astraは分数回の微分と遅れの項が要りそうだと推測していたが、係数を決める探索はしきれなかったという。
検索を切っても46問、論文を「覚えている」
ネットなしの条件でも、AstraとOpusは46問に正解した。論文によると、多くの問題は過去の論文の細かい式を前提にしていて、その論文はほとんどの場合AIに渡していない。付録A.11.6の問題は、人間なら背景の論文(arXiv:1607.03908)を読まないと記号の意味すら分からないと著者たちは書く。著者たちの見立ては、AIが物理の研究論文の大部分を覚えていて、大事な式を調べずに書き出せる、というものだ。
間違え方にも差があった。論文はOpusの誤りを「細かい」と書く。ネットありの条件でOpusが落とした4問のうち1問は全員が解けなかったA.1.2で、残りは、問題文ではなく参考にした論文の初期値を使った(A.1.3)、級数の収束の速さについて誤った結論を書いた(A.9.1)、出力の上限に何度もぶつかって答えを出せなかった(A.7.1)。一方、Gemini と GLM はネットありの条件のページ時間の問題で5次元用の式をそのまま4次元に使い、ネットなしの条件では Gemini・GLM・DeepSeek が面積ではなく線(測地線)の長さを計算していた。論文はこれらを「専門家なら気づく誤り」の例として挙げている。
数学の次は、理論物理
論文は冒頭で、AIエージェントの影響をこう書いている。
This impact is most visible in mathematics, where important open problems [1, 2, 3, 4], including the Navier–Stokes Millennium Prize problem [5] and the “dying percolation conjecture” [6], have been solved by AI agents.
(この影響がいちばんはっきり出ているのは数学で、ナビエ・ストークス方程式のミレニアム懸賞問題や「dying percolation conjecture」を含む重要な未解決問題が、AIエージェントによって解かれた。)
So far, autonomous agents have had a less significant impact on theoretical physics and have not achieved a notable breakthrough. But they have rapidly become important in research.
(これまで、自律的なエージェントが理論物理に与えた影響はそれほど大きくなく、目立った突破もまだない。それでも、研究の場ではすぐに欠かせないものになった。)
このサイトでも、9月のOpenAIのナビエ・ストークス方程式の発表(ナビエ・ストークス方程式の解決と論争)、「100以上の未解決問題」の発表(数学者はもう要らない?)、10月に公開された数学の結果372件(OpenAIの数学論文722本を難しさ順に)を追ってきた。今回の論文は、数学に続いて理論物理でも、研究レベルの具体的な計算でAIが専門家を抜かし始めたことを、出題者自身の手で示したものとして読める(この一文は当サイトの見立て)。
表4を足し直して確かめたこと
動画を作る過程で、筆者は論文の付録Cの表4(50問×5つのAI×2条件の合否)を自分で集計し直した。各AIの正解数は本文の数字と一致し、「ほかのAIの正解がすべてネットありのAstraの正解に含まれる」という本文の記述も表から確かめられた。トークンの合計も、表2の値と問題ごとの表の合計が一致した。
論文自身は、測り方について次の点を書いている。各AIは1回ずつしか走らせておらず、温度が0でない以上、正解率には統計的な揺らぎが残る(ネットあり・なしの差もその範囲内だと著者たちは書く)。問題は「AIに一切触れていない」ものではなく、出題者がAIの助けを使って解いた問題もあり、データの漏れは否定できない。A.10.1の答えは実験の後に論文として公開された。A.9.1とA.11.4は問題文の約束ごとが十分に指定されておらず、採点で実際に出た解釈を両方認めている。
この記事の数字の出どころ
- 正解数・トークン・料金は論文の表2〜4と本文IV章、問題の中身は付録A、逆問題の答えは付録B。1問あたり約2.3ドルは表3の合計116.28ドルを50で割った値
- 英文の引用は論文のHTML版(arXiv 2610.16733v1)の本文から
- 「数学に続いて理論物理でも専門家を抜かし始めた」は当サイトの見立てで、論文の主張としては上に引用した2段落(序論・考察)の範囲
数学、物理の次はどの学問で同じことが起きると思うか、動画のコメント欄で聞かせてほしい。次の論文が出たら、同じ物差しで続報を書く。
この記事でよく聞かれること
- TheoPhysEvalとは何ですか
- 2026年10月9日にarXivに投稿された論文(arXiv 2610.16733)と、そこで使われた理論物理の問題集です。著者は35人。世界の専門家から集めた、答えが公開されていない研究レベルの問題50問(11分野)で、AIエージェントがヒントなしで解けるかを測っています。論文によると、典型的な問題は世界の第一人者でだいたい1日かそれ以下、隣の分野の専門家ならずっと長くかかる難しさです。
- GPT-6 Astraは何問解けましたか
- 論文によると、Codexで動かしたGPT-6 Astraは、論文の検索とプログラムの実行ができる条件(論文の言う realistic track)で50問中49問に正解しました(98%)。インターネットを切った条件では46問です。2位はClaude CodeのClaude Opus 5.5で、どちらの条件も46問でした。
- 「専門家の模範解答の誤り」とは何のことですか
- 論文の本文によると、著者たちは最初、Astraが他にも複数の問題で誤ったと判定しました。ところが出題した専門家に相談しながら詳しく調べ直すと、元の解答の方に細かい誤りがあり、専門家が解答を直すと、その全部でAstraの答えが正解になりました。何問だったかの数は本文に書かれていません。
- AIが解けなかった問題はありますか
- 付録Aの問題A.1.2(グラフから元の微分方程式を当てる逆問題)は、5つのAIがどの条件でも解けませんでした。付録Bによると出題者の答えは分数回の微分と遅れの項を含む方程式で、著者たちは「厳密に見れば不公平に見えるかもしれない」と書きつつ、実際の研究を表す問題として入れたと説明しています。
出典・参照資料
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
OpenAIが社内AIの数学論文722本を公開 372件を難しさ順に並べ、取り上げた問題のLean証明を手元のMacで照合した
OpenAIが社内AIの数学論文722本を公開372件を難しさ順に並べ、取り上げた問題のLean証明を手元のMacで照合した
 動画
数学者はもう要らない? OpenAI「100以上の未解決問題を解決」を起点に、数学者自身が「まだ早い」と言っていた記録、4か月の快進撃、他の仕事との違い、3つの反論を一次ソースで並べる
数学者はもう要らない?OpenAI「100以上の未解決問題を解決」を起点に、数学者自身が「まだ早い」と言っていた記録、4か月の快進撃、他の仕事との違い、3つの反論を一次ソースで並べる
 動画
OpenAIが「AIがナビエ・ストークスを解いた」と発表 同じ日に数学者が公にした「パクられた疑惑」、何が証明され、どこまで検証されたか
OpenAIが「AIがナビエ・ストークスを解いた」と発表同じ日に数学者が公にした「パクられた疑惑」、何が証明され、どこまで検証されたか
 動画
GPT-6 Astra公開 自社比較表では首位、独立指標では5位、価格はFable 5.1と同額の$10/$50
GPT-6 Astra公開自社比較表では首位、独立指標では5位、価格はFable 5.1と同額の$10/$50
 動画
OpenAIの未公開AI「Astra」が未解決問題10問を解いた 機械検証付きの証明を読む
OpenAIの未公開AI「Astra」が未解決問題10問を解いた機械検証付きの証明を読む
 動画
2026年9月、AIで歴史上の暗号が次々に読まれた エニグマ4通、ナポレオン軍の手紙、孫文あての電報まで
2026年9月、AIで歴史上の暗号が次々に読まれたエニグマ4通、ナポレオン軍の手紙、孫文あての電報まで
研究室の装置にCodexをつないだら何が起きたか MITの量子ビット校正はGPT-5.6 Solが「信号が明瞭なら」自律で完走、弱い信号では研究者の助言が必要。抗菌分子探索の研究室はChatGPT・Codexを「分野の壁を越える道具」に。OpenAIの研究者事例2本(日本語版あり)
研究室の装置にCodexをつないだら何が起きたかMITの量子ビット校正はGPT-5.6 Solが「信号が明瞭なら」自律で完走、弱い信号では研究者の助言が必要。抗菌分子探索の研究室はChatGPT・Codexを「分野の壁を越える道具」に。OpenAIの研究者事例2本(日本語版あり)