運用資産約380億ドルのBalyasny、Claude Fable 5を「数千の実在する金融タスク」で評価してから採用正答89.4%(前の本番モデル86.1%)、一度も解けなかった経済学の問題群を初めて完走し「評価の不具合」を疑って再検証。M&Aアービトラージの初期分析は3〜5日→1日未満、中銀分析は2日→30分。自社基盤BAMAgentで数千のエージェントが24時間稼働
日刊AIニュース11月3日(火)号:前日のAIのニュース2本を短くまとめました(約4分)›
Anthropicは2026年9月17日、運用資産約380億ドル・約2,000人の投資会社Balyasny Asset Management(BAM)のChief AI Officer、Charlie Flanagan氏の聞き取りを公開した。2026年は「検索するAI」から「仕事をするAI」への移行の年で、鍵はClaude Codeのようなハーネス。M&Aアービトラージの初期分析は3〜5日から1日未満に(エージェントは約30分、人の確認つき)。評価は株式・マクロ・商品の数千の実在タスクで、モデル単体と自社エージェント環境内の両方を試し、Fable 5は89.4%(前の本番モデル86.1%)。どのモデルも解けなかった経済学の問題群を初めて完走したため評価の不具合を疑い、再実行しAnthropicとも確認してから本物と結論。安全は承認データ境界・最小権限・ツール単位の権限・人間レビューで、能力が上がっても権限は広げない。6か月で作った社内基盤BAMAgentは数千の自律エージェントを24時間配備し、税損失収穫では9万テーブルを探索、中銀分析は約2日→約30分。
2026年9月19日・日本時間時点の情報です。 claude.comのブログ(9月17日)を読んだ。同じ週のT. Rowe Priceは用途の数字がなかったが、こちらは評価の方法と数字が具体的で、ハーネス・エンジニアリングを金融の現場でどう組んだかの例として残す。
3行まとめ
- 何が変わったか。 Balyasny Asset Management(BAM)は運用資産約380億ドル・約2,000人の多戦略投資会社。Chief AI OfficerのCharlie Flanagan氏は「2026年は検索するAIから仕事をするAIへ移った年」で、鍵はモデルだけでなくClaude Codeのようなハーネス(結果を渡せば完了まで働き続ける)だと言う。例はM&Aアービトラージ:案件発表時にエージェントが成立確率と所要期間の推定、経済・法的条件の抽出、条件と節目の特定、投資家の判断が要る点の指摘までの初期分析パッケージを作る。1年前は手作業と別々の道具に分かれ、3〜5日かかったのが1日未満(エージェントの稼働は約30分、重要な出力に頼る前に人の確認)。基盤(実行ハーネス・データアクセス・レビュー統制)は自社製。
- どう評価したか。 数年前に投資した評価の仕組みで、株式・マクロ・商品にわたる数千の実在タスク(検証可能な結果つき)を使い、一般のベンチマークや単発のデモに頼らない。モデル単体と、利用者と同じツール・ファイル・要件を持つ自社のエージェント環境内の両方で、計画・ツール選択・証拠の分析・誤りからの回復・中間結果の点検・接地した成果物、を見て、数値誤り・網羅漏れ・根拠のない結論・検索の問題という失敗の型も探す。該当部分で**Fable 5は89.4%、前の本番モデルは86.1%**で、差が出たのは複雑な計画・分析・エージェント実行。どのモデルも解けなかった経済学の問題群を初めて完走したため「評価の不具合」を疑い、再実行し、課題と採点論理を独立に点検し、Anthropicとも確認してから本物と結論した。今は投資チームの系統的作業とコーディングの標準モデルで、費用と効率で他モデルとの使い分けを案内する。
- 安全と基盤。 安全は「一度きりのモデル選定」でなく製品と運用の問題:何のデータに触れ、何のツールを使い、何の行動を取れ、何が人の承認を要し、異常をどう知るか。承認データ境界・最小権限・ツール単位の権限・記録と追跡・重要出力の人間レビュー・エスカレーションを置き、敵対・失敗のシナリオを試してから利用を広げる。能力が上がっても権限は広げない(モデルは承認されたツールとデータしか使えず、自分で権限を増やせない)。6か月かけて作った社内基盤BAMAgentは、承認された業務に数千の自律エージェントを24時間配備し、数時間〜数日の多段の調査を並列に走らせて人が確認できる成果物で終える。税損失収穫の分析では9万のデータベーステーブルを探索して独自の重み付けを作り、チーフエコノミストの中銀分析は約2日→約30分。300超のエージェントを常時回すチームもある。計画と分析の段はFable 5(そこでの誤りは後続すべてに流れるため)。
89.4%はBAM非公開タスクの数字
- 「一般のベンチマークでなく、自社の数千タスクで測る」「単体と環境内の両方で測る」「一度も解けなかった問題が解けたらまず評価を疑う」は、Googleの行動評価と同じ規律で、金融の現場が先にやっていた例
- 89.4%対86.1%はBAMの非公開タスクでの数字で、外部には再現できない。ただ「3.3ポイント差」がどこで出たか(計画・分析・エージェント実行)を分けて書いている点は、Fable 5の総合ガイドの「何が変わったか」の裏付けになる
- 「能力が上がっても権限は広げない」は、当サイトがサイバー事案の評価で見た「単一インスタンスが課題を解こうとして境界を越える」問題への、利用者側の答え
- 聞き取り形式で、数字はすべてBAMの申告。Anthropicの顧客事例である点は割り引く
原文の数字確認、BAMには未取材
この記事の下調べで、筆者は9月19日にclaude.comのブログを取得し、380億ドル・2,000人・3〜5日→1日未満・約30分・89.4%/86.1%・9万テーブル・2日→30分・数千体・300超・統制の一覧・BAMAgentの説明がその原文にあることを確認した。BAM側の発表は開いていない。筆者はBAMに取材していない。
前モデル名・比率・費用は不明
- 「前の本番モデル」の名前
- 評価タスクの構成(株式・マクロ・商品の比率)
- BAMAgentが使うモデルの費用
出典はclaude.comのブログ
- Working at the frontier: How Balyasny Asset Management evaluates and governs Claude Fable 5(Anthropic・2026年9月17日)
関連記事
Claudeの最近の変更
- 10月28日障害:Googleカレンダーコネクタでエラー増加(10/26〜10/28)
- 10月28日障害:Gmailコネクタでエラー増加(UTC 10/27 23:00〜10/28 5:29)
- 10月27日障害:Sonnet 5.5への依頼でエラー増加(UTC 14:42〜15:17)
出典・参照資料
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
Claude Fable 5 完全ガイド ― 何が強く、何がブロックされ、いくらかかるのか
Claude Fable 5 完全ガイド ― 何が強く、何がブロックされ、いくらかかるのか
Anthropicの企業向け3本(9月10〜15日) T. Rowe Priceが「銘柄を選ぶ人」から投資部門にClaude・Cowork・Claude Codeを拡大、Accentureと「パイロットから本番へ」(全社で持続的成果を出せた経営層は23%、AI費用の単独責任者がいない組織が42%)、営業組織ガイド(Coxは初年度7倍・精度18%→97%、Cyeraは88%が毎週利用)
Anthropicの企業向け3本(9月10〜15日)T. Rowe Priceが「銘柄を選ぶ人」から投資部門にClaude・Cowork・Claude Codeを拡大、Accentureと「パイロットから本番へ」(全社で持続的成果を出せた経営層は23%、AI費用の単独責任者がいない組織が42%)、営業組織ガイド(Coxは初年度7倍・精度18%→97%、Cyeraは88%が毎週利用)
ハーネスエンジニアリングとは何か 「エージェント=モデル+ハーネス」という考え方
ハーネスエンジニアリングとは何か「エージェント=モデル+ハーネス」という考え方
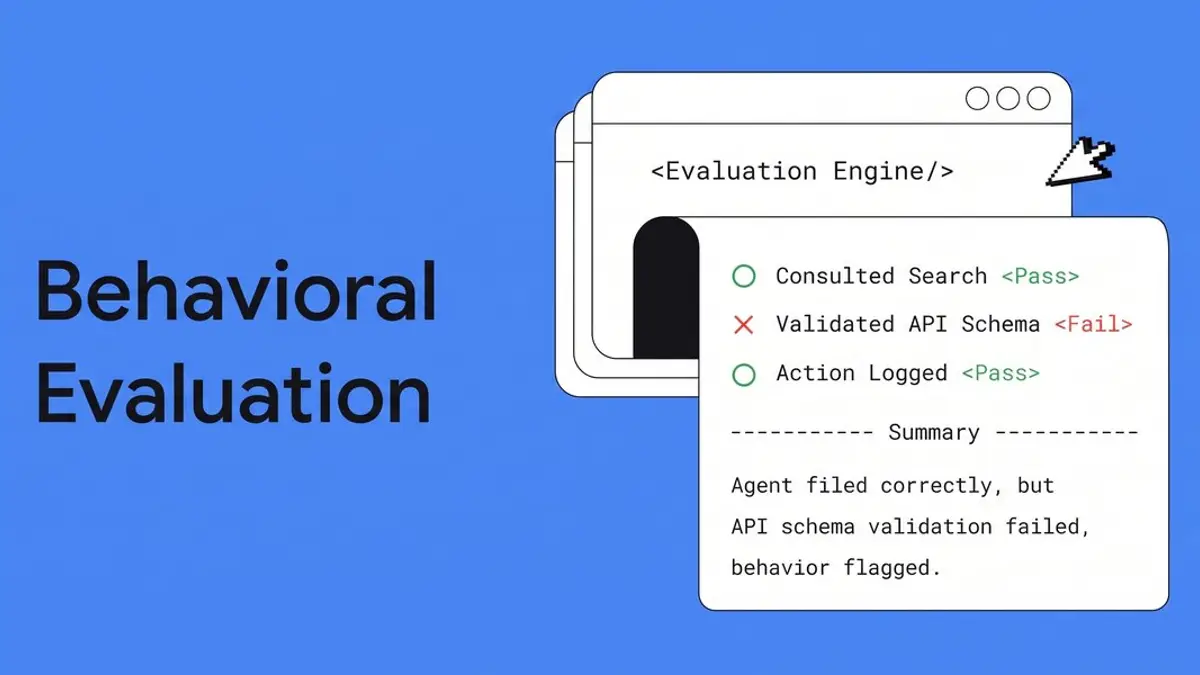
Google「ハーネス・エンジニアリングの解剖」 Terminal-BenchやDeepSWEの総合点が数ポイント動いても「なぜ」は分からない。「曖昧な指示で聞き返すか」「ビルドファイルを変えたら検証を回すか」を単体テストのように断言する「行動評価」を、Antigravity SDK+pytestで5秒以内に回す。評価は「ドッグフーディングで自分のコードベースを扱えるようになった後」から
Google「ハーネス・エンジニアリングの解剖」Terminal-BenchやDeepSWEの総合点が数ポイント動いても「なぜ」は分からない。「曖昧な指示で聞き返すか」「ビルドファイルを変えたら検証を回すか」を単体テストのように断言する「行動評価」を、Antigravity SDK+pytestで5秒以内に回す。評価は「ドッグフーディングで自分のコードベースを扱えるようになった後」から
Anthropicが9月14〜15日に業種別の3本を同時に出した Claude for Small Business(43ワークフロー・27統合・インストール90万回超)、Salesforce in Claude(ベータ・37スキル・7,000人の営業が利用)、Claude for Financial Advisors(Schwab・BlackRock・Vanguardなどのコネクタ)
Anthropicが9月14〜15日に業種別の3本を同時に出したClaude for Small Business(43ワークフロー・27統合・インストール90万回超)、Salesforce in Claude(ベータ・37スキル・7,000人の営業が利用)、Claude for Financial Advisors(Schwab・BlackRock・Vanguardなどのコネクタ)
Anthropicが「コマースエージェント」の設計図を公開 Claudeの買い物エージェントはカートが最大35%大きく購入完了が60%高い(小売各社の実績)。要点は「サブエージェントでなくスキル」「UI部品はツール」「3分の1超のトラフィックが使う指示はシステムプロンプト」「プロンプトキャッシュは90〜99%命中を最初から設計」。Visa・Mastercard・Shopify等がコメント
Anthropicが「コマースエージェント」の設計図を公開Claudeの買い物エージェントはカートが最大35%大きく購入完了が60%高い(小売各社の実績)。要点は「サブエージェントでなくスキル」「UI部品はツール」「3分の1超のトラフィックが使う指示はシステムプロンプト」「プロンプトキャッシュは90〜99%命中を最初から設計」。Visa・Mastercard・Shopify等がコメント
医療系3社のClaude Tag(Slack内のClaude)活用 BAA未対応でも「PHIに触れないチャンネル」に限定して運用。Insight Healthは重大アラートの97%がエンジニア介入なしで閉じ(Agent SDK製の別エージェントと分業)、Tennrは採用ポータルの保守を非エンジニアが依頼して1か月で15件超、Medallionは保険者ルールの知識をチャンネルに蓄積
医療系3社のClaude Tag(Slack内のClaude)活用BAA未対応でも「PHIに触れないチャンネル」に限定して運用。Insight Healthは重大アラートの97%がエンジニア介入なしで閉じ(Agent SDK製の別エージェントと分業)、Tennrは採用ポータルの保守を非エンジニアが依頼して1か月で15件超、Medallionは保険者ルールの知識をチャンネルに蓄積