大規模言語モデル(LLM)の記事
「大規模言語モデル(LLM)」に関連するAIニュースと解説、183本。新しい順に並べています。
大規模言語モデル(LLM) の記事:183件
Anthropic、Claude(クロード)の推論を抜き出す蒸留攻撃への防御を公開 抜き出された推論トークンは導入後に10〜100分の1へ(同社の推計)
Anthropic、Claude(クロード)の推論を抜き出す蒸留攻撃への防御を公開抜き出された推論トークンは導入後に10〜100分の1へ(同社の推計)
研究
AWS、Amazon BedrockのGrok 4.7(グロック)でエージェントを作る手順と実測を公開 72回中67回正解、xhighは18回すべて正解、lowは出力トークン約8分の1
AWS、Amazon BedrockのGrok 4.7(グロック)でエージェントを作る手順と実測を公開72回中67回正解、xhighは18回すべて正解、lowは出力トークン約8分の1
検証
AWS、Amazon SageMaker(セージメーカー)AIの推論コンテナでMoEモデルのカーネルを最適化 H200で最大10%のスループット向上、初回トークンまでの時間は最大9%短縮
AWS、Amazon SageMaker(セージメーカー)AIの推論コンテナでMoEモデルのカーネルを最適化H200で最大10%のスループット向上、初回トークンまでの時間は最大9%短縮
検証
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開 LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
Liquid AI(リキッドAI)、アクティブ2Bの推論モデル「LFM2.5-24B-A2B」をオープンウェイトで公開LiveClawは48.09でQwen3.6-35B-A3Bの38.19を上回る(同社測定)
モデル
 動画
Meta「Muse Wonder(ミューズ ワンダー)」発表 公式の比較表14項目中7項目でFable 5.1・Astra・Opus 5.5を上回る、APIはOpus 5.5と同じ入力4ドル・出力20ドル
Meta「Muse Wonder(ミューズ ワンダー)」発表公式の比較表14項目中7項目でFable 5.1・Astra・Opus 5.5を上回る、APIはOpus 5.5と同じ入力4ドル・出力20ドル
モデル
Anthropic(アンスロピック)、小型AIが安価なIoT機器上で自己複製できるまで「数か月」の可能性と発表 9Bモデルは9種のハードのうち8種で推論サーバーを立ち上げた
Anthropic(アンスロピック)、小型AIが安価なIoT機器上で自己複製できるまで「数か月」の可能性と発表9Bモデルは9種のハードのうち8種で推論サーバーを立ち上げた
研究
Apple機械学習研究、AIエージェントが自分で文脈の圧縮時機を決める「SELFCOMPACT(セルフコンパクト)」の論文を公開 数学で最大18.1点、検索で5〜9点改善、1問あたりコスト30〜70%減
Apple機械学習研究、AIエージェントが自分で文脈の圧縮時機を決める「SELFCOMPACT(セルフコンパクト)」の論文を公開数学で最大18.1点、検索で5〜9点改善、1問あたりコスト30〜70%減
研究
NVIDIAとプリンストン大Dao AI Lab、ハイブリッドモデルの推論を速める「ReplaySSM(リプレイSSM)」を公開 SSMカーネル1.46〜1.80倍、投機的デコードはvLLM比1.85〜2.10倍
NVIDIAとプリンストン大Dao AI Lab、ハイブリッドモデルの推論を速める「ReplaySSM(リプレイSSM)」を公開SSMカーネル1.46〜1.80倍、投機的デコードはvLLM比1.85〜2.10倍
研究
Gemini 2.5 Pro/Flashの終了日、Google Cloud側は「2026年10月20日」・Gemini API側は「発表なし」 公式2ページの記載差を確認した
Gemini 2.5 Pro/Flashの終了日、Google Cloud側は「2026年10月20日」・Gemini API側は「発表なし」公式2ページの記載差を確認した
プロダクト
 動画
Mistral Large 4が登場、米国・欧州製のオープンウェイトで首位 公式グラフでは法務とサイバーで中国勢を上回り、コーディングと金融ではGLM-5.3やKimi K3が上
Mistral Large 4が登場、米国・欧州製のオープンウェイトで首位公式グラフでは法務とサイバーで中国勢を上回り、コーディングと金融ではGLM-5.3やKimi K3が上
モデル実機で検証
 動画
ドイツ製AI「Kolibri」を手元のMacで動かした 78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
ドイツ製AI「Kolibri」を手元のMacで動かした78Bでも1語ごとに動くのは3.46B、2bit版で毎秒約111トークン。日本語の質問には答えられなかった
モデル実機で検証
Poe(Quoraの複数AIチャットアプリ)とは GPT・Claude・Geminiを1つのアプリで使う仕組みと料金プラン
Poe(Quoraの複数AIチャットアプリ)とはGPT・Claude・Geminiを1つのアプリで使う仕組みと料金プラン
プロダクト
DeepSeekとは何か アプリは無料・APIは従量課金、データは中国のサーバーに保存するとプライバシーポリシーに明記
DeepSeekとは何かアプリは無料・APIは従量課金、データは中国のサーバーに保存するとプライバシーポリシーに明記
モデル
 動画
OpenAIがKimiの開発元Moonshot AIの関係者を名指し 暗号を破らずに「隠された推論」を抜き出そうとした蒸留攻撃の中身
OpenAIがKimiの開発元Moonshot AIの関係者を名指し暗号を破らずに「隠された推論」を抜き出そうとした蒸留攻撃の中身
業界実機で検証
 動画
ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表 総合点は7か月前のQwen3.5・Gemma 4に届かず
ELYZA、国産llm-jp-4を土台にした新モデル2つと「AIがAIを作る」研究組織を発表総合点は7か月前のQwen3.5・Gemma 4に届かず
モデル実機で検証
 動画
2026年9月、AIで歴史上の暗号が次々に読まれた エニグマ4通、ナポレオン軍の手紙、孫文あての電報まで
2026年9月、AIで歴史上の暗号が次々に読まれたエニグマ4通、ナポレオン軍の手紙、孫文あての電報まで
研究実機で検証
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本 ①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
Liquid AIの小型モデルLFM2.5を「速く・正確に」する2本①DSparkの草稿モデル(約300M)で投機的デコード、出力は同一のままH100で最大3.18倍・M4 Max MacBookで最大2.87倍、関数呼び出しの遅延を57%削減 ②350MモデルをGRPOで100ステップ(無料枠のColab)微調整し、構造化出力の遵守率をIFStructで22.6%→29.7%
検証
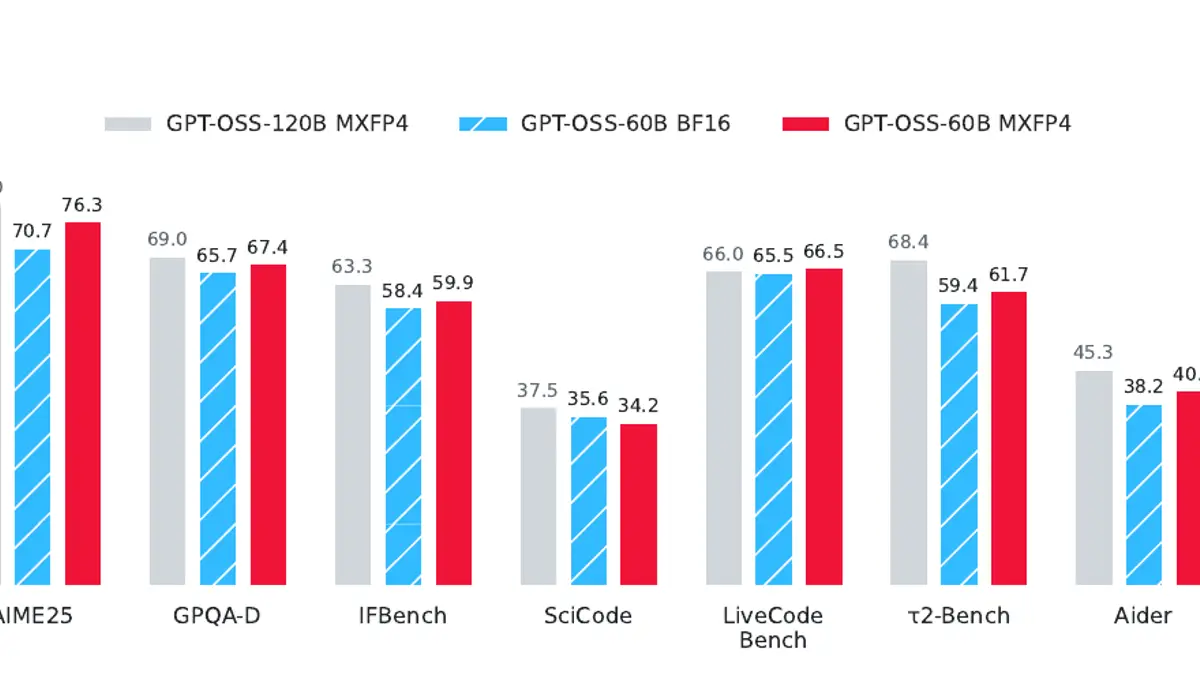
Multiverse Computing「Quantization-Aware Healing」 GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
Multiverse Computing「Quantization-Aware Healing」GPT-OSS 120Bを60Bに圧縮し4ビット(MXFP4)に量子化したモデルが、元のbfloat16版を9ベンチマーク中7で上回る。秘訣は「回復済みの16ビット版」でなく「圧縮前の120B」を教師にKL蒸留すること。長文脈推論+7.4、AIME 2025+5.6
検証
 動画
Gemini 4 Argonを発表 公式の比較表19項目のうち13項目で1位、出力の上限は100万トークン、最初に使えるのはサイバー防御の専門家だけ
Gemini 4 Argonを発表公式の比較表19項目のうち13項目で1位、出力の上限は100万トークン、最初に使えるのはサイバー防御の専門家だけ
モデル
Ai2「BenchMIRT」 100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)
Ai2「BenchMIRT」100のLLM×16ベンチマーク×3.4万問の結果を多次元の項目反応理論で分解し、教えていないのに「安全性」と「一般推論」の2軸を毎回復元。バイアス評価のBBQは安全性より推論と相関、危険知識のWMDPは推論が強いほど低得点、HarmBenchの著作権問題は安全性と相関しない。問題を10%残すだけで順位がほぼ保たれ、未見問題の正誤予測は79%(平均点方式70%)
検証
IBM「Granite 4.2」の作り方 初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
IBM「Granite 4.2」の作り方初の推論特化の密なモデル3B・8B・30B(Apache 2.0、日本語を含む12言語)。SFTの31.6%がエージェント軌跡(Codex・Gemini CLI等のハーネスで生成)、RLはRLVR→SWE→端末→検索→RLHFの階段で8B・30Bだけ実環境のエージェントRL。30BはSWE-Bench Verified 57.00
検証
【リーク】Claude Sonnet 5.5、Anthropicがステルステスト中と投稿 提携先には2つ目のチェックポイント、公開は「来週」
【リーク】Claude Sonnet 5.5、Anthropicがステルステスト中と投稿提携先には2つ目のチェックポイント、公開は「来週」
モデル
【リーク】Gemini 4 Pro、Google社内でチェックポイント「argon」が出回り始めたと投稿 出力の上限は25万6,000トークン、新しい版「barium-b」の投稿も
【リーク】Gemini 4 Pro、Google社内でチェックポイント「argon」が出回り始めたと投稿出力の上限は25万6,000トークン、新しい版「barium-b」の投稿も
モデル
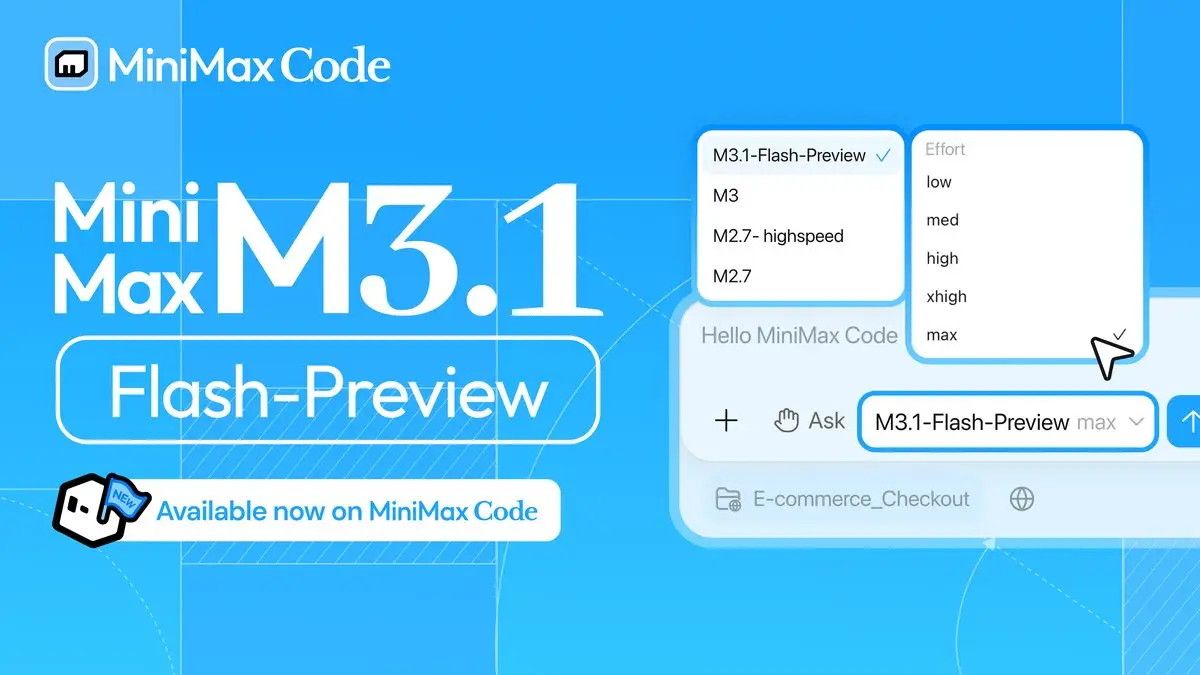
MiniMax、新モデル「M3.1-Flash-Preview」をMiniMax Codeで公開 推論の強さは5段階、前日のリークは「来週」と書いていた
MiniMax、新モデル「M3.1-Flash-Preview」をMiniMax Codeで公開推論の強さは5段階、前日のリークは「来週」と書いていた
モデル