Claude(クロード)Fable 5.2はいつ使う?Anthropic公式の答えは「普段はOpus 5.5のmediumから」effortの選び方とFable 5.2への頼み方を公式の記事とガイドから整理
日刊AIニュース11月10日(火)号:前日のAIのニュース3本を短くまとめました(約5分)›
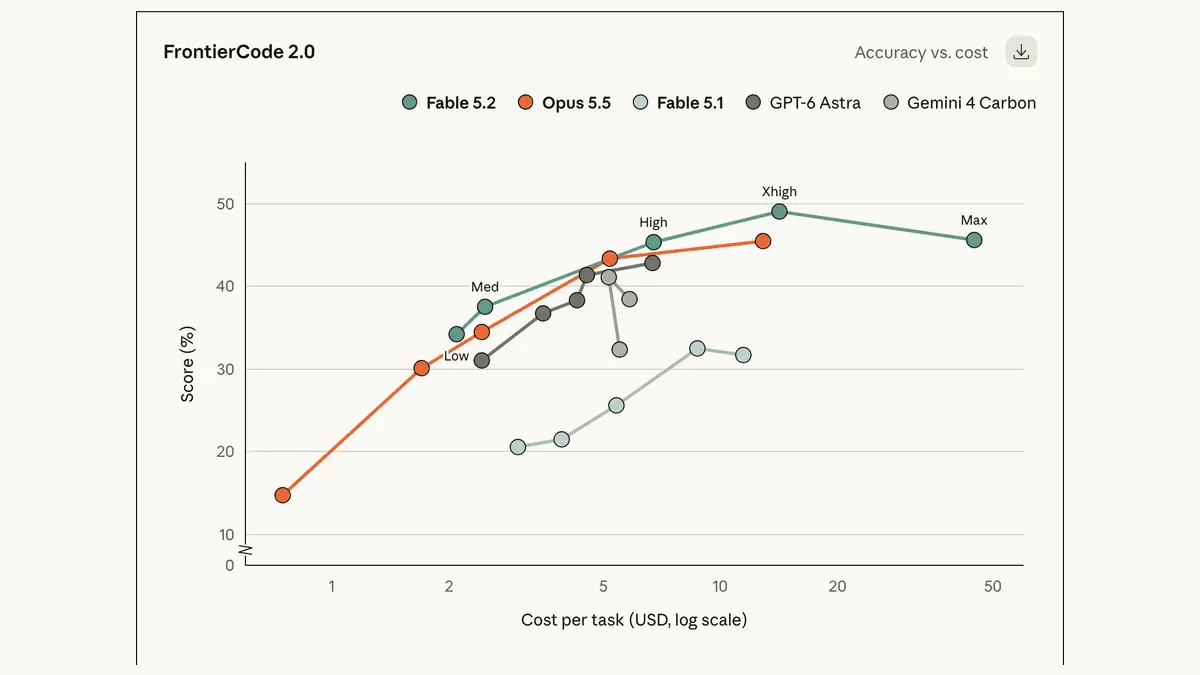
Anthropicの開発者ブログ(claude.dev)は2026年11月9日付の記事で、4つのClaudeの選び方を示した。答えは「ほとんどの仕事はOpus 5.5のmediumから」で、仕事別の早見表11行のうちFable 5.2が置かれているのは2行。発表記事のFrontierCode 2.0では、Fable 5.2のhigh(45.3%)がOpus 5.5のmax(45.5%)とほぼ同じ点で、1件あたりの費用は約半分だった。公式ガイドが示すFable 5.2への頼み方(先に消す指示と、癖が出た時だけ足す文6つ)もまとめる。
目次
- Fable 5.2 に上げる条件は3つ、下げる先は2つ
- effort を1段動かすと、点と費用はどれだけ変わるか
- 「Opus 5.5 を high より上げる前に Fable 5.2」の元になっている数字
- 結果が足りない時に試す順番
- 早見表11行をモデルごとに数え直すと、Fable 5.2 は2行だった
- 文脈は細く保ち、モデルを替えるのは区切りで
- 4つを組み合わせる方法は3つ、公式の書き方は慎重
- Fable 5.2 への頼み方は「足す前に引く」
- 癖が出た時だけ足す6つと、そのたびに払う物
- 頼んでも断られる時の分類は5つ
- API で自分の仕組みを作っている人が変える所
- 記事の最後は「自分の仕事で測れ」
- 公開ページを開かずに書いた部分と、数字の出どころ
- 参照した公式の4ページ
- この記事でよく聞かれること
Anthropicの開発者ブログ(claude.dev)は2026年11月9日付の記事「Which Claude model should you build with?」で、いま使える4つのClaude(Fable 5.2・Opus 5.5・Sonnet 5.5・Haiku 5.5)の選び方を示しました。答えは「ほとんどの仕事はOpus 5.5のmediumから始める」です。medium は effort(エフォート=モデルが考える深さの設定)の5段階(low・medium・high・xhigh・max)の下から2番目で、Fable 5.2 は一番難しい仕事に上げるモデルという位置づけでした。この記事では、Fable 5.2 向けの公式ガイド「Prompting Claude Fable 5.2」と移行ガイドの内容も合わせて、モデルとeffortの選び方、Fable 5.2への頼み方を順に整理します。同じ内容を動画(YouTube・26分)でも解説しています。
3行まとめ
- claude.dev の記事(Addy Osmani氏・2026年11月9日付)の答えは「ほとんどの仕事は Opus 5.5 の medium から」。仕事別の早見表11行のうち、Fable 5.2 が置かれているのは2行(大きな移行・設計の計画・サブエージェントの指揮と、深い調査・科学や数量の分析)。
- Anthropic の発表記事によると、FrontierCode 2.0 で Fable 5.2 の high は45.3%、Opus 5.5 の max は45.5%で、1件あたりの費用は Fable 5.2 が約半分。記事は「Opus 5.5 を high より上に上げる前に Fable 5.2 を試す」と書いている。
- 公式ガイドの頼み方は「足す前に引く」。考えるなという行・モデルに見せているトークンの予算・硬い文体のルール・溜まった「絶対に〜するな」を先に見直し、足す文は癖が出た時だけ1つずつ。足すたびに出力トークンが約20%〜1.5倍に増える例が載っている。
本記事の内容は、2026年11月10日朝(日本時間)に確認したものです。数字はすべて Anthropic が自社のテストとして公表したもので、筆者が測ったものではありません。
Fable 5.2 に上げる条件は3つ、下げる先は2つ
claude.dev の記事は、出発点を Opus 5.5 の medium に置いたうえで、そこから動かす条件を書いています。理由として挙げているのは、Claude Code の初期設定が Opus 5.5 であることと、1トークンあたりの値段が Fable 5.2 の半分であることです。
- Fable 5.2 に上げる:コーディング・金融・科学の一番難しい技術の仕事/Opus 5.5 を high にしても足りない時/人が見ていない長い実行
- 下げる:範囲のはっきりした毎日の仕事は Sonnet 5.5、単純で数の多い仕事は Haiku 5.5
- 例外:仕様がはっきりしていても、移行や性能の改善のように難しい仕事は Opus 5.5 のまま。大がかりな移行は Fable 5.2
もう1つの Mythos 5.2 は、審査を通った組織だけが使えるサイバーセキュリティと生命科学の研究向けだと記事は説明しています。後で出てくる仕事別の早見表に並んでいるのも、上の4つです。発表時の料金や Fable と Mythos の違いは、Fable 5.2 と Mythos 5.2 の発表をまとめた記事に書いています。
effort を1段動かすと、点と費用はどれだけ変わるか
記事は、モデルを替える前に effort を動かすことを勧めています。目安として載っているのが、Opus 5.5 を SWE-bench Pro で測った数字です(high が基準)。
| effort | 点(high との差) | 1件あたりの費用 |
|---|---|---|
| low | 約8ポイント低い | high の約3分の1 |
| medium | 約2.5ポイント低い | high の約70% |
| high | 基準 | 100% |
| xhigh | 約1.4ポイント高い | high の2.5倍 |
medium に下げても点は約2.5ポイントしか下がらず、xhigh に上げても約1.4ポイントしか上がらない、という形です。記事は合わせて、effort を上げてもモデルが持っていない知識や腕前は増えないこと、high を超えると effort を1段上げる費用が1つ上のモデルに替える費用と並ぶことがあることを書いています。
「Opus 5.5 を high より上げる前に Fable 5.2」の元になっている数字
Anthropic の発表記事には、その実例が載っています。FrontierCode 2.0 というコーディングのテストの結果です。
| 設定 | 点 | 1件あたりの費用 |
|---|---|---|
| Opus 5.5 を max | 45.5% | — |
| Fable 5.2 を high | 45.3% | Opus 5.5 の max の約半分 |
1トークンの値段は Fable 5.2 が Opus 5.5 の2倍ですが、仕事を1件終わらせる費用では約半分になっています。claude.dev の記事は、値段表の1トークンの値段と仕事1件を終わらせる費用は別の物だと説明し、Opus 5.5 を high より上に上げる前に Fable 5.2 を試すよう書いています。
発表記事には、Fable 5.2 を低い effort で回した例がほかに3つあります。
| テスト | Fable 5.2 の effort | Opus 5.5 の最高点と比べて | 費用 |
|---|---|---|---|
| WANDR(データ集め) | medium | 並ぶ | 約40% |
| Humanity's Last Exam | low | 並ぶ | 10分の1未満 |
| Chartography(図を読む) | medium | 上回る(66.4% と 64.4%) | 10分の1未満 |
逆向きの例も claude.dev の記事にあります。Terminal-Bench 3.0 では、1つ前の Fable 5.1 の max が58.0%、Opus 5.5 の high が58.9%で、Opus 5.5 が使ったトークンは半分でした。上のモデルに替えれば必ず得になる、とは書かれていません。
結果が足りない時に試す順番
記事は、足りない時の順番を決めています。
- モデルが自分の仕事を確かめられるようにする
- effort を1段上げる
- 1つ上のモデルへ替える。その時は前より低い effort から始める
結果を自動で確かめられる仕事には、もっと安いやり方も載っています。全部を low で回し、落ちた物だけ high でやり直す方法です。記事によると、SWE-bench Pro の一部でこのやり方は約97%が通って1件あたり約0.17ドル、全部を high で回すと95.3%で1件あたり0.29ドルでした。
費用を比べる時の注意も書かれています。20問の検索のテストでは、2問が費用全体の43%を占めました。一番難しい仕事を抜いて比べると、費用を見誤ることになります。
速さについては、人が返事を待つ場面は Sonnet 5.5 の low か medium から始めるよう勧めています。Fable 5.2 の出力は Fable 5.1 より最大30%速く、発表記事によると Opus 5.5 と Fable 5.2 には値段の上がる fast mode があり、Fable 5.2 では出力が最大2.5倍速くなります。
早見表11行をモデルごとに数え直すと、Fable 5.2 は2行だった
記事には仕事別の早見表があり、仕事の種類ごとに最初のモデルと最初の effort が並んでいます。筆者がこの表をモデルごとに並べ替えて数えたところ、Opus 5.5 が3行、Sonnet 5.5 が4行、Haiku 5.5 が2行、Fable 5.2 が2行でした。下の表は、筆者が訳して並べ替えたものです。
| 仕事 | 最初のモデル | 最初の effort |
|---|---|---|
| 毎日の開発とデバッグ・機能づくり | Opus 5.5 | medium(足りなければ high) |
| 画面の操作・画像の多い仕事 | Opus 5.5 | medium |
| まだ決めかねている時 | Opus 5.5 | medium |
| チャット・対話 | Sonnet 5.5 | low か medium |
| 範囲の決まったコーディング | Sonnet 5.5 | medium(足りなければ high) |
| 毎日の文書・スライド・表計算 | Sonnet 5.5 | high(Claude Code は medium) |
| 繰り返し走らせるエージェントの仕事 | Sonnet 5.5 | medium |
| 分類・振り分け・タグ付け・大量の抜き出し | Haiku 5.5 | medium |
| 探す・ログを読む・要約するサブエージェント | Haiku 5.5 か Sonnet 5.5 | そのモデルの初期値 |
| 大きな移行・設計の計画・サブエージェントの指揮 | Fable 5.2 | medium(足りなければ high) |
| 深い調査・科学や数量の分析 | Fable 5.2 | medium(足りなければ high) |
サブエージェントの行は「Haiku 5.5 か Sonnet 5.5」と書かれているので、ここでは Haiku 5.5 に数えました。例外として、複雑な財務モデルや、大量の資料から組み立てる文書は Opus 5.5 から始めるよう書かれています。
新しい一番上のモデルが出ると、全部をそれに任せたくなります。数え直してみると、公式が Fable 5.2 を最初に置いている仕事は11行のうち2行で、残りの9行は Opus 5.5 以下でした。
Fable 5.2 を使う時の effort
claude.dev の記事によると、Claude のアプリと Claude Code の初期値は medium で、早見表も medium から始めて足りなければ high へ上げる形です。API は初期値が high です。公式ガイドは各段を次のように説明しています。
- low:短いやり取り、指示のはっきりした仕事、数の多いサブエージェント。Anthropic のテストでは、Fable 5.2 の low の成績は Fable 5.1 をもっと高い effort で回した時に近かった
- medium:対話しながらのコーディング、チャット、毎日の知識作業
- high:難しいコーディング、調査、人が見ていない長い実行。能力の伸びの大半は high までに出る
- xhigh:一番難しい長時間の仕事で、伸びを自分で測れた時だけ
- max:モデルの天井を測る時か、時間もトークンも気にしない仕事
選ぶ時に知っておく癖として、ガイドは3つ挙げています。effort が低いほど仕事の途中で止まりやすいこと、high 以上ではあいさつへの返事を含めてほとんどの返事の前に考えること、effort を変えても返事の長さはほとんど変わらないこと(長さや口調はプロンプトで指定する)です。そのうえで、1つの仕事の中で段を混ぜる使い方を勧めています。計画は medium で立て、人が離れる長い実行の所だけ上げる、という形です。
文脈は細く保ち、モデルを替えるのは区切りで
100万トークンを読めるからといって、資料を全部入れておくのは勧められていません。記事によると、入れた分はターンのたびに送り直されるので、毎ターンの費用になります。記事の教えは、主役のモデルが大きいほど主役の文脈を細く保つことです。高いモデルの文脈は判断のために空けておき、長い読み物は安いサブエージェントに読ませて要約だけ受け取ります。
途中でモデルを替える時の注意も2つ載っています。
- 替えた最初のターンで、会話全体をキャッシュに書き直す費用がかかる。替えるのは区切りのいい所にし、Claude Code なら先に
/compactを実行するか、短い計画を書いて新しいセッションで始める - 下のモデルから上のモデルへ上げる時は、上のモデルが下のモデルの考えた跡を読める。逆に Fable 5.2 からほかのモデルへ移ると、それまでの考えた跡は全部落ちる
4つを組み合わせる方法は3つ、公式の書き方は慎重
記事のデモでは、1つのネットショップの開発を4つのモデルで分けています。Fable 5.2 が JavaScript から TypeScript への移行、Opus 5.5 が月額課金の機能、Sonnet 5.5 が商品ページ、Haiku 5.5 がお客さんのメッセージの仕分けです。組み合わせ方として載っているのは次の3つです。
1. サブエージェントを小さいモデルで動かす。 Claude Code ではサブエージェントの定義に model: haiku か model: sonnet と書きます。小さいモデルに渡すのは、ファイル探し・テストの実行・ログ読みのように、間違いにすぐ気づける仕事だけで、コードの編集と判断は主役のモデルに残します。記事は設定の注意を2つ挙げています。元から入っている Explore というサブエージェントは、いまは必ず Haiku で動くわけではなく、セッションのモデルで動きます。探索を安くしたいなら、Explore という名前のサブエージェントを自分で定義して model: haiku と書きます。もう1つは opusplan という別名で、計画を Opus、実行を Sonnet に任せるため、コードの編集が Sonnet に行きます。記事は、初期設定にする前に自分の仕事で測るよう書いています。
2. アドバイザー(助言役)を付ける。 安いモデルが仕事を進め、途中で強いモデルに助言を求める仕組みです。ここは公式の書き方が慎重で、費用のガイドに載っている4つの組み合わせのうち、単独で使うよりはっきり良かった物は1つも無かったとしています。役に立つのは進める側が実際に相談した時だけなので、相談する割合を先に測るよう勧めています。
3. 大きな仕事を割って、安いモデルたちに配る。 1つの文脈に入りきらない仕事の分け方です。約2,200万トークンのソースコードから欠陥を探す社内のテストでは、Opus 5.5 が指揮して Sonnet 5.5 を最大25体動かし、Opus 5.5 が初期の effort で1人でやる場合より費用が約3分の1安く、点はほぼ同じでした。前の結果に次が頼る1本道の仕事や、1つの文脈に収まる仕事ではやらない、とも書かれています。発表記事によると、Fable 5.2 はこの指揮役にもアドバイザーにもなれます。
Fable 5.2 への頼み方は「足す前に引く」
ここからは公式ガイドの内容です。ガイドが示す順番は、まず昔のモデルのために書いた指示を読み直して消し、次に長い仕事を走らせて癖を見て、出た癖にだけ対策の文を1つずつ足す、というものです。足すたびに、変化とトークンの増え方を測ります。
先に見直す物は次のとおりです。
| 見直す物 | ガイドの説明 |
|---|---|
| 「考えずにすぐ答えろ」という種類の行 | Fable 5.1 はたいてい従った。Anthropic のテストで、Fable 5.2 は medium 以上ではこの行があっても考えるのをやめなかった。行を消して effort を下げる |
| モデルに見せているトークンの予算 | high と xhigh のコーディングで、大きな予算の表示を外すと、成績は同じで費用が下がった |
| 「その答えは済んだ物として扱え」という種類の文 | 考える量は減るが、自分の前の答えの間違いを指摘することがずっと少なくなる |
| 硬い文体のルール(1文は20語以内など) | そのまま守るので、文章がぶつ切りになる |
| メモリ・メモ・指示ファイルに溜まった注意書き | 書かれた通りに守るので、要らない承認を求めたり普通の作業を止めたりする |
最後の「溜まった注意書き」には、Anthropic が模擬の仕事で測った数字が載っています。道具が混んでいて呼び出しが失敗した時に、やり直すかどうかを見たテストです。
| 状況 | 結果 |
|---|---|
| やり直しについて何も書いていない | ほぼ毎回やり直す |
| 前のセッションのメモを12個ほど入れ、その1つが「やり直すな」 | やり直しは10回に4回ほどまで減った |
| 「絶対に〜するな」のルール・メモ・レビュー役の条件がある所へ、「やり直しは承認なしでよい」と1行足す | ほぼ0回から約半分まで戻った(「もっと自由に動いていい」という大まかな指示では変わらなかった) |
| その1行があっても、レビュー役のエージェントの「最初のエラーで止まれ」が文脈にある | 3回に1回ほどやり直さなかった(Fable 5.1 と Opus 5.5 はやり直した) |
| 「絶対に〜するな」というルールの下で、責任者が承認した手順 | 進めたのは10回に1回ほど |
| 同じルールを「先に了承を取れ」という書き方に変える | 10回に9回進めた |
直し方としてガイドが挙げているのは、理由の無くなった注意を消すこと、絶対のルールには範囲と理由を書き足すこと、承認の要らない手順は名前を挙げて書くことです。危険な操作や元に戻せない操作の確認は、アプリの側に残すよう書かれています。
癖が出た時だけ足す6つと、そのたびに払う物
ガイドには貼って使える文が載っていますが、どれも「その癖が出た時だけ」足すよう書かれています。足した時に増える物も一緒に書かれているので、並べます。文の原文は公式ページにあり、ここでは要点だけを日本語にしています。
| 出る癖 | 足す物 | Anthropic のテストの結果 | 払う物 |
|---|---|---|---|
| 長い仕事を途中で終える(low と medium で起きやすい) | 「最後までやり切る」段落。エラーやタイムアウトは調べて乗り越え、触るなと印の付いたファイル・わざと渡されていない権限・安全の仕組みは越えずに報告する、という区別を書く | やれる仕事を残して終わるセッションが約半分に減った | 出力トークンが約30%増える |
| 承認のルールを書かれた通りに守って止まる | 「続けて」だけで送らず、何を承認したかを書く。ルールは対象の操作を名指しする | 「会話の外の人へ送る時は承認が要る」というルールで、同僚へのふつうの依頼の約半分を出さずに止めた | — |
| 今ある構造に付け足す(同じコードの繰り返しもある) | 「このコードベースはあなたの物」という趣旨の1文 | 重複したコードをまとめた割合が1割未満から約半分に上がった | 出力トークンが約1.5倍。頼んでいない変更(テストやドキュメントが多い)。既存の機能のふるまいの変更が6〜10回に1回 |
| 道具を使っている間、何も言わない | (a) ハーネスが無言の道具呼び出しを数え、何回か続いたら一言うながす文を差し込む (b) 始める前に1行、途中は短く、最後に単独で読めるまとめ、という文 | (a) 一番長い無言の時間がおよそ半分になった (b) 最初の道具を呼ぶ前に毎回ひとこと言うようになった | (a) トークンも時間も目立っては増えなかった (b) 出力トークンが約20%増える |
| サブエージェントを使いすぎる | まず、サブエージェントが動くモデルと、指示やスキルの中の「委任しろ」という行を見直す。それでも多ければ、サブエージェントを起動する道具の説明文を、費用から書き直す | 委任が約3分の1減り、仕事の成功率は同じだった | — |
| 最後の報告が読みにくい | 「頭はいいが事情を知らない読み手に向けて書く」段落 | 報告の密度が下がった | — |
コードの持ち主の1文には、注意が付いています。最後のまとめに小さな変更が載らないことが多いので、まとめだけでなく差分を見ること、なるべく触ってほしくないコードではこの文を入れないことです。
途中経過の文を足しても、道具を何回か呼ぶ間は黙ることがあるとガイドは書いています。Fable 5.2 に向いているのは、任せておいて後で結果を見に来る長い仕事だという説明です。
頼んでも断られる時の分類は5つ
発表記事によると、Fable 5.2 には安全のための分類器が付いていて、ペネトレーションテストやエクスプロイト生成のような高リスクのサイバー作業と、研究寄りの生物学の多くが止まります。止まった時は別のモデルが代わりに答え、サイバーは Opus 4.8、生物学は Opus 5 です。初期のテストでは、止められた回数が Fable 5.1 より約55%少なかったとされています。claude.dev の記事によると、Claude Code ではどのモデルでやり直したかが記録の中に表示されます。
移行ガイドでは、断る理由の分類は5つです。
cyber:サイバー攻撃の助けになりうる物bio:生物の害の助けになりうる物frontier_llm:競合するAIモデルの開発の手助けreasoning_extraction:モデルの内部の推論を本文に書き出させる依頼general_harms:それ以外の利用規約の領域
使う側が自分で気をつけられるのは4つ目です。プロンプトやスキルや道具の説明文に「考えた中身を本文に書き出せ」という指示があると、この分類で断られる原因になります。ガイドによると、この分類には代わりのモデルが用意されていないので、そのまま断りとして返ってきます。
API で自分の仕組みを作っている人が変える所
claude.dev の記事によると、Claude Code・Agent SDK・Managed Agents で動かしている人は、何も変えなくて構いません。確認が要るのは、自分でリクエストを組み立てている場合です。
一番大きいのは履歴の書き換えです。Fable 5.2 が考えた跡(thinking ブロック)は、それより前にあるシステムプロンプト・道具の定義・メッセージと結び付いていて、その部分を書き換えてから送り返すとリクエストが400エラーで返ります。Fable 5.2 ではすべての API アカウントが対象です。対策は、セッションの間はシステムプロンプトと道具の定義を固定し、メッセージは後ろへ足すだけにすることです。どこで書き換えているか分からない時は、切り替える前に公式の3段階の確認を回すよう移行ガイドに書かれています。
ほかにエラーになる指定は4つあります。
- 考える機能を切る指定。返事の先頭が考えのブロックのことがあるので、種類を見て読む
- 道具を必ず呼ばせる
tool_choiceのanyとtool。autoにして道具にstrictを付け、いつ使うかをプロンプトに書く - 返事の書き出しを先に埋める prefill。形式はシステムプロンプトで指示する
- 前のコンピューター操作の道具
computer_20251124。新しいcomputer_toolset_20260801で宣言する(Amazon Bedrock だけは前の道具も動く)
移行ガイドには契約まわりの条件も載っています。データの保持は30日が条件であること、顧客が管理する暗号鍵(CMEK)を使っている組織では構造化出力が使えないこと、レート制限は Fable 5.2 だけ別枠であること、アドバイザーの道具で Fable 5.2 を進める側にするならアドバイザーも Fable 5.2 か Mythos 5.2 にすることです。
記事の最後は「自分の仕事で測れ」
claude.dev の記事は、公表された数字は出発点のモデルを決めるための物だとして、最後に測り方を書いています。本物の仕事を抜き出して合否の判定を付け、候補のモデルを2つか3つの effort で走らせ、点と費用を1枚のグラフに置く、という手順です。複数のモデルを組み合わせる構成は、どの単独の点にも勝った時だけ残すよう書かれています。
Claude Code で手早く確かめる方法も載っています。溜まっている仕事を1つ選び、/model で2つのモデルに解かせて、/usage の数字を比べます。
公開ページを開かずに書いた部分と、数字の出どころ
この記事の材料の読み方には差があります。
- claude.dev の記事:11月10日朝(日本時間)に筆者がブラウザで本文を読みました。早見表は筆者の訳と並べ替えで、原文の表そのままではありません
- 発表記事:11月10日未明(日本時間)に保存した本文で確かめました
- 「Prompting Claude Fable 5.2」と移行ガイド:筆者が読んだのは、Claude Code に同梱されている Anthropic の移行ガイド(Fable 5.2 の章)です。頼み方の節は、詳しくは Prompting Claude Fable 5.2 のページを見るよう案内しています。platform.claude.com の公開ページそのものは筆者の環境から開けておらず、公開ページの文面と1行ずつ突き合わせてはいません。2つのページが公開されていることと題名は、検索結果で確かめました。貼って使う文の原文をこの記事に載せていないのは、このためです
数字はどれも Anthropic が自社で測ったものです。「模擬の仕事」「小さなコーディングの仕事」「短い仕事」のように条件が限られていて、移行ガイド自身が、effort の設定は自分の評価で測り直すこと、足した文は1つずつ変化とトークンの増え方を測ることを勧めています。筆者はこれらの数字を再現していません。
動画の中に出てくる指示の文面とコードの画面は、説明のために作った例です。
参照した公式の4ページ
- Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku(Claude 開発者ブログ・Addy Osmani 氏・2026年11月9日付)
- Introducing Claude Fable 5.2 and Claude Mythos 5.2(Anthropic・2026年11月9日)
- Prompting Claude Fable 5.2(Claude Platform Docs)
- Claude Fable 5.2 and Claude Mythos 5.2 migration guide(Claude Platform Docs)
動画では、effort の表やグラフを画面に出しながら同じ順番で説明しています。自分の仕事ではどのモデルのどの effort に落ち着いたか、動画のコメント欄で教えてもらえると、続きの題材選びの参考にします。
Claudeの最近の変更
- 11月9日新機能:Claude Fable 5.2とMythos 5.2を発表
- 11月8日障害:Fable 5.1への依頼でエラー増加(UTC 8:18〜8:32)
- 11月6日新機能:Enterprise向けにプロジェクトタグで費用を集計(ベータ)
この記事でよく聞かれること
- Claude Fable 5.2はいつ使うべきですか?
- Anthropicの開発者ブログ(claude.dev)の記事によると、ほとんどの仕事はOpus 5.5のmediumから始めます。Fable 5.2に上げるのは、コーディング・金融・科学の一番難しい技術の仕事、Opus 5.5をhighにしても足りない時、人が見ていない長い実行の3つです。記事は、Opus 5.5をhighより上に上げる前にFable 5.2を試すよう書いています。
- Fable 5.2のeffortはどれから始めればいいですか?
- claude.devの記事によると、ClaudeのアプリとClaude Codeの初期値はmediumで、仕事別の早見表もmediumから始めて足りなければhighへ上げる形です。APIの初期値はhighです。公式ガイドは、能力の伸びの大半はhighまでに出ること、xhighは伸びを自分で測れた一番難しい長時間の仕事だけ、maxはモデルの天井を測る時などに使うことを勧めています。
- Fable 5.2に頼む時、プロンプトで最初に見直す所はどこですか?
- 公式ガイドは、文を足す前に昔のモデル向けに書いた指示を見直すよう勧めています。「考えずにすぐ答えろ」という行、モデルに見せているトークンの予算、硬い文体のルール、メモや指示ファイルに溜まった「絶対に〜するな」の注意書きです。足す文は、癖が出た時にだけ1つずつ足し、そのたびに変化とトークンの増え方を測ります。
- Fable 5.2に断られるのはどんな時ですか?
- Anthropicの発表記事によると、ペネトレーションテストやエクスプロイト生成のような高リスクのサイバー作業と、研究寄りの生物学の多くが安全のための分類器で止まります。止まった時は、サイバーならOpus 4.8、生物学ならOpus 5が代わりに答えます。公式の移行ガイドでは、断る理由の分類はcyber・bio・frontier_llm・reasoning_extraction・general_harmsの5つです。
出典・参照資料
- 一次資料Which Claude model should you build with? Fable, Opus, Sonnet, or Haiku — Claude 開発者ブログ(Addy Osmani・2026年11月9日) ↗
- 一次資料Introducing Claude Fable 5.2 and Claude Mythos 5.2 — Anthropic公式 ↗
- 一次資料Prompting Claude Fable 5.2 — Claude Platform Docs ↗
- 一次資料Claude Fable 5.2 and Claude Mythos 5.2 migration guide — Claude Platform Docs ↗
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
Anthropic、Claude(クロード)Fable 5.2とMythos(ミトス)5.2を公開 入力$8・出力$40でFable 5.1から2割下げ、公式の表ではOpus 5.5やGPT-6 Astraを多くの項目で上回る
Anthropic、Claude(クロード)Fable 5.2とMythos(ミトス)5.2を公開入力$8・出力$40でFable 5.1から2割下げ、公式の表ではOpus 5.5やGPT-6 Astraを多くの項目で上回る
GitHub Copilot(コパイロット)、Claude(クロード)Fable 5.2を一般提供 Pro+・Max・Business・Enterprise向け、既定でデータ保持、法人は管理者の有効化が必要
GitHub Copilot(コパイロット)、Claude(クロード)Fable 5.2を一般提供Pro+・Max・Business・Enterprise向け、既定でデータ保持、法人は管理者の有効化が必要
 動画
Claude Fable 5.1公式プロンプトガイド全17項目を読む effortは5段階で既定はhigh、「箇条書きを使うな」「見つけたことは最後まで取っておけ」の旧指示が今は逆効果、公式が配る貼るだけの文面11本
Claude Fable 5.1公式プロンプトガイド全17項目を読むeffortは5段階で既定はhigh、「箇条書きを使うな」「見つけたことは最後まで取っておけ」の旧指示が今は逆効果、公式が配る貼るだけの文面11本
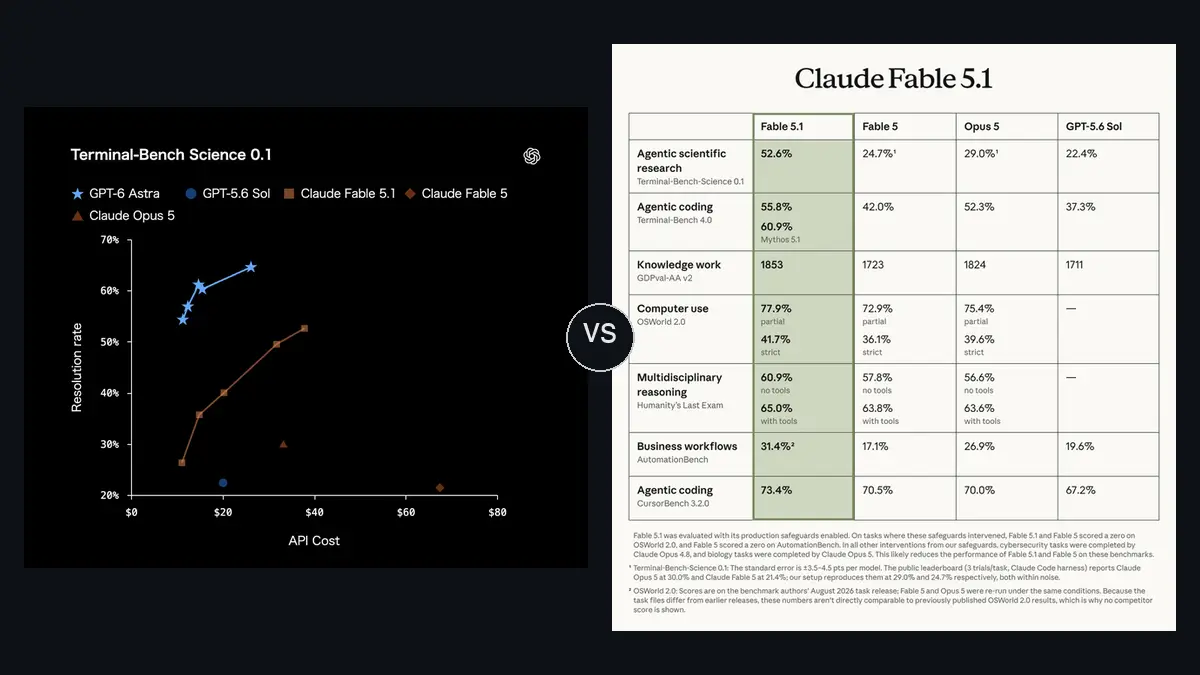
GPT-6 Astra vs Claude Fable 5.1 比較 同じ$10/$50で何が違うか。公式ベンチの突合・独立指標・プラン別に使える条件・キャッシュ単価の4倍差を1枚に
GPT-6 Astra vs Claude Fable 5.1 比較同じ$10/$50で何が違うか。公式ベンチの突合・独立指標・プラン別に使える条件・キャッシュ単価の4倍差を1枚に
 動画
Claude Haiku 5.5の使い方 公式プロンプトガイドの貼る文・effortの選び方・10万トークンの壁・Claude Codeで検索係にする設定
Claude Haiku 5.5の使い方公式プロンプトガイドの貼る文・effortの選び方・10万トークンの壁・Claude Codeで検索係にする設定
 動画
Claude Sonnet 5.5公式プロンプトガイドを全部読む effortは測り直し、途中で止まる・やりすぎる・調べない、困りごと11個と貼る文
Claude Sonnet 5.5公式プロンプトガイドを全部読むeffortは測り直し、途中で止まる・やりすぎる・調べない、困りごと11個と貼る文
 動画
Claude Opus 5.5公式プロンプトガイドを全部読む effortの既定がhighからmediumへ、無人エージェントが止まる4つの型と公式の対策文、貼るだけのプロンプト6型
Claude Opus 5.5公式プロンプトガイドを全部読むeffortの既定がhighからmediumへ、無人エージェントが止まる4つの型と公式の対策文、貼るだけのプロンプト6型