ByteDance、動画生成AI「Seedance 2.0」公開マルチモーダル入力で15秒映像を生成
ByteDanceのSEED Labが動画生成モデルSeedance 2.0を公開。テキスト・画像・音声・動画の4種同時入力に対応し、15秒のマルチショット映像をステレオ音声付きで生成する。
目次
- ByteDanceのSEED Labが2026年2月12日にAI動画生成モデル「Seedance 2.0」を公開した
- テキスト・画像(最大9枚)・動画(最大3クリップ)・音声(最大3クリップ)の4モダリティ同時入力に対応
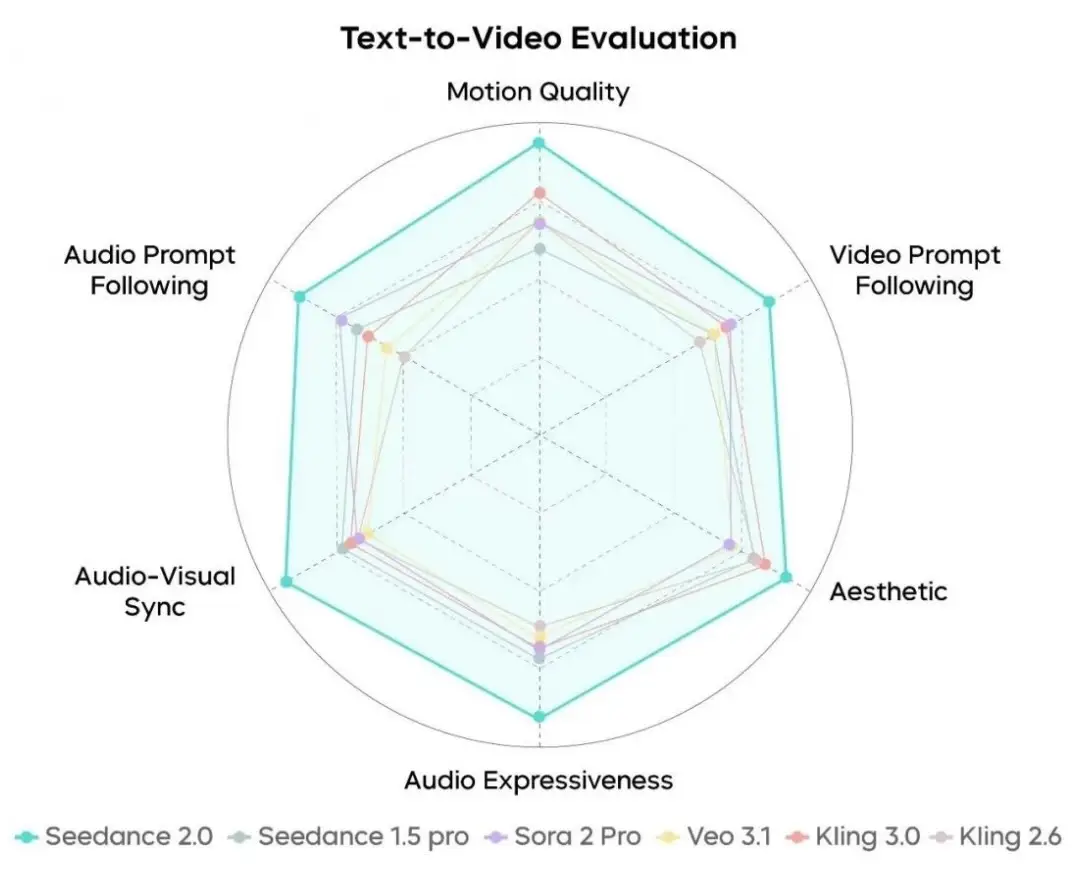
- フィギュアスケートのペア演技など複雑なインタラクションシーンで動きの整合性と物理的正確性が向上したと発表
SEED Labが公開した4入力対応モデル
ByteDanceの研究開発部門であるSEED Labは2026年2月12日、AI動画生成モデル「Seedance 2.0」を公開したと公式ブログで発表した。
Seedance 2.0の特徴は、テキスト・画像・音声・動画の4種類の入力を同時に受け付ける点にある。公式発表によると、1回のプロンプトでテキスト指示に加え、最大9枚の画像、3本の動画クリップ、3本の音声クリップを組み合わせた入力が可能だ。出力は15秒間のマルチショット映像で、デュアルチャンネルのステレオ音声が付随する。
動きの整合性と物理的正確性
SEED Labの公式発表では、Seedance 2.0で特に改善されたポイントとして「動きの整合性」(motion consistency)と「物理的正確性」(physical accuracy)が挙げられている。
具体例として、フィギュアスケートのペア演技のような複雑なインタラクションシーンが示されている。2人の人物が同期した動きを行う場面で、各フレーム間の動作のつながりが破綻しにくくなったと公式ブログは説明している。
キャラクターアニメーションの一貫性
もう一つの改善点として、動画編集や延長タスクにおけるキャラクターの外見・声・行動の論理的な流れの保持が挙げられている。公式発表によれば、被写体の見た目と声が動画全体を通じて維持され、アクションの論理的な流れが途切れにくくなった。
これは動画生成AIにおいて頻出する課題――生成されたキャラクターがフレームごとに服装や顔の特徴が変わってしまう問題――に対処するものと読み取れる。
どこで使えるのか──公式が案内している3つの入口
公式ブログの中国語版には、英語版に無い「体験入口」の記載がある。2026年8月14日に確認した時点で、次の3経路が案内されている。
| 入口 | 公式ブログの案内(原文) |
|---|---|
| 即梦AI(ウェブ版) | 即梦网页端-视频生成-选择 Seedance 2.0 |
| 豆包 App | 豆包 App 对话框-Seedance2.0-选择 2.0 模型 |
| 火山方舟 体験センター | 火山方舟体验中心-选择 Doubao-Seedance-2.0 |
公式ブログは「目前,Seedance 2.0 已上线即梦AI、豆包等平台」(現時点でSeedance 2.0は即梦AI・豆包などのプラットフォームで公開済み)と書いている。即梦AIと、海外向けに使われる「Dreamina」という名称との関係、および火山方舟(Volcano Ark)がByteDanceのモデル提供基盤であることは、本記事が参照した公式ブログ(英語版・中国語版とも)には記載が無く、確認できていない。手がかりとしては、後述のArtificial AnalysisのVideo Arenaリーダーボード上でモデル名が「Dreamina Seedance 2.0 720p」(Creator: ByteDance Seed)と表記されている点がある。モデル名は公式ブログでは「Doubao-Seedance-2.0」とも表記される。
料金については、公式ブログ(英語版・中国語版とも)に記載が無い。即梦AI/Dreaminaと火山方舟の料金ページも2026年8月14日に確認したが、当方の環境では単価やプラン金額を読み取れなかったため、本記事には金額を書かない。
公式ブログに記載が無い項目
読者が知りたくても、公式ブログからは確認できない項目を明示しておく(2026年8月14日時点)。
- 対応解像度:記載なし。ただしArtificial AnalysisのArenaに登録されているモデル名は「Dreamina Seedance 2.0 720p」で、少なくとも720pの提供面が存在することは読み取れる
- 生成尺の選択肢:記載なし。公式が示すのは「15秒」の一点のみで、それより短い/長い尺を選べるかは書かれていない
- アスペクト比・フレームレート:記載なし
- 日本からの利用可否、日本語プロンプトの扱い:記載なし
動画生成AI市場における位置づけ
2026年に入り、動画生成AIの分野ではOpenAIのSora、Google DeepMindのVeo、Runway、Pika Labsなど複数のプレイヤーが競合している。ByteDanceがSeedance 2.0で4モダリティ同時入力と15秒マルチショット生成を打ち出したことは、入力の柔軟性という軸で差別化を図る動きといえる。
一方、生成された動画の品質は実際に使用して確認するまで判断できない部分が大きい。公式ブログに掲載されたデモ映像は選りすぐりの事例である可能性があり、一般的な利用シーンでの安定性は別途検証が必要だ。
Artificial Analysis の Arena では何位か
公開時点では「一部報道でArena高スコアが言及されている」という段階だったが、Artificial AnalysisのVideo Arenaリーダーボードは公開されており、直接確認できる。2026年8月14日に確認した結果は次のとおり。
| 部門 | 順位 | Eloスコア | 比較サンプル数 |
|---|---|---|---|
| Text to Video | 3位 | 1,222 | 19,276 |
| Image to Video | 1位 | 1,198 | 12,575 |
リーダーボード上の表記は両部門とも「Dreamina Seedance 2.0 720p」(Creator: ByteDance Seed)。Text to Videoで上位に立っているのはGoogleのGemini Omni Flash(Elo 1,241)とMiniMax H3(Elo 1,238)で、3者の差は19ポイント以内に収まっている。Image to Videoでは逆にSeedance 2.0が首位で、2位のMiniMax H3が1,192、3位のGemini Omni Flashが1,191だった。
つまり「テキストから作る」より「画像を動かす」方で相対的に強い、という順位の付き方をしている。ただしArenaのEloは人間の一対比較投票を集計した相対値で、投票が積み上がるたびに動く。ここに書いた数値は2026年8月14日時点のスナップショットであり、読む時点では変わっている可能性がある。Elo方式のリーダーボードをどこまで信用してよいかはLLMベンチマークの読み方で整理している。
一次ソースと確認できなかった項目
出典:
- Official Launch of Seedance 2.0 - ByteDance Seed(一次ソース、2026年2月12日公開)
- Seedance 2.0 公式ブログ 中国語版(一次ソース、体験入口の記載。2026年8月14日確認)
- Video Arena: Text to Video Leaderboard - Artificial Analysis(2026年8月14日確認)
- Video Arena: Image to Video Leaderboard - Artificial Analysis(2026年8月14日確認)
但し書き:
- 本記事の技術的特徴に関する記述は、ByteDance SEED Labの公式ブログ発表に基づいている。独立した第三者による検証結果ではない
- 公開当初、一部報道ではArtificial Analysis Video Arenaでの高スコアが言及されていたが公式発表では未確認だった。その後、Arenaのリーダーボードを直接確認して順位とEloスコアを本文に追記した(2026年8月14日確認)。ByteDanceの公式ブログ自体にArenaの順位・スコアの記載は無く、Arenaの数値の出典はArtificial Analysisである
- 本記事の発表内容は2026年2月12日時点、体験入口とArenaスコアは2026年8月14日時点の確認結果に基づく
- 料金は確認できていない。公式ブログに記載が無く、即梦AI/Dreaminaおよび火山方舟の料金ページからも当方では金額を読み取れなかったため、本記事に金額は書いていない
- 解像度・生成尺の選択肢・アスペクト比・フレームレート・日本からの利用可否は、公式ブログに記載が無いため書いていない。720pという表記はArtificial Analysisのリーダーボード上のモデル名から読み取ったもので、ByteDanceの公式記載ではない
- 「即梦AIは海外向けにはDreaminaの名称で提供されている」「火山方舟はByteDanceのモデル提供基盤である」という背景説明は、本記事が参照した4つの一次ソース(公式ブログ英語版・中国語版、Artificial Analysisの2リーダーボード)のいずれにも明記が無く、確認できていない。手がかりとして、Artificial Analysis上のモデル表記が「Dreamina Seedance 2.0 720p」(Creator: ByteDance Seed)となっている点のみ記載する
出典に無い断定を修正した記録
- 2026-08-14: 「即梦AIは海外向けにはDreaminaの名称で提供されている」「火山方舟はByteDanceのモデル提供基盤」という断定を、出典に記載が無い旨を明示する表現に修正。ByteDance公式ブログ(英語版・中国語版)、Artificial Analysisの2リーダーボードのいずれにも該当の記載が無いことを確認した
- 2026-08-14: 水増し指摘を受け、情報量のない一般的助言を1文削除
出典・参照資料
この記事の解説動画
YouTubeで見る ↗
大きいニュースはYouTubeでも解説しています。Xでは新着記事をお知らせしています。
コメント
まだコメントはありません。最初のコメントを書いてみませんか?
AIについて聞きたいことはありますか?
質問箱で無料で受け付けています。回答は公開され、他の方の参考にもなります。
質問箱を見る →関連記事
 動画
ByteDance「Seedance 2.5」登場 1回の生成で30秒、2回まで延長可能に
ByteDance「Seedance 2.5」登場1回の生成で30秒、2回まで延長可能に
「AI動画の税金」にLumaが挑む 承認するまでレンダリングしない「Luma Scenes」の設計
「AI動画の税金」にLumaが挑む承認するまでレンダリングしない「Luma Scenes」の設計
 動画
AI動画に自然な日本語を話させるには 表記を変えて誤読を1語ずつ潰した記録
AI動画に自然な日本語を話させるには表記を変えて誤読を1語ずつ潰した記録
モデルを乗り換えると同じプロンプトが効かない Veoは構造化推奨、Sora 2は「長いほど不自由」
モデルを乗り換えると同じプロンプトが効かないVeoは構造化推奨、Sora 2は「長いほど不自由」
ByteDanceが「見ながら聞きながら話す」全二重AIを実運用投入 音声だけのGPT系リアルタイムAIとの違いはどこにあるか
ByteDanceが「見ながら聞きながら話す」全二重AIを実運用投入音声だけのGPT系リアルタイムAIとの違いはどこにあるか
CapCut(キャップカット)のログイン方法 公式の入口は capcut.com、「オンラインで試す」からGoogle・TikTokなどで入る。無料・日本語、入れない時の直し方と年齢条件【2026年10月版】
CapCut(キャップカット)のログイン方法公式の入口は capcut.com、「オンラインで試す」からGoogle・TikTokなどで入る。無料・日本語、入れない時の直し方と年齢条件【2026年10月版】
TwelveLabs、動画編集AIコパイロット「Rodeo」を発表、自然言語で素材を検索・編集
TwelveLabs、動画編集AIコパイロット「Rodeo」を発表、自然言語で素材を検索・編集